Groundline: ein RAG-Dienst, der selbst ausrechnet, wie viel Geld er spart
Ein Nebenprojekt mit FastAPI und LangGraph: hybride Suche, Neuordnung, Selbstprüfung und ein semantischer Cache, der 60 bis 65 Prozent der wiederholten Fragen abdeckt. Die Ersparnis ist direkt in der Oberfläche sichtbar.
In den letzten Tagen habe ich ein Nebenprojekt namens Groundline gebaut und möchte erzählen, warum ich es genau so gemacht habe und welche Aufgaben es löst.
Warum noch ein RAG
Eine einfache Dokumentensuche zu bauen ist heute kein Problem mehr, es gibt Tausende Tutorials. Aber die meisten Lern- und Demoprojekte bleiben in der Phase «super, es antwortet irgendwie» stehen. In einem echten Unternehmen lautet die Hauptfrage anders: Was kostet der Betrieb.
Jeder Aufruf eines Sprachmodells kostet echtes Geld und Sekunden Wartezeit. Wenn Nutzer dasselbe immer wieder mit anderen Worten fragen und das System jedes Mal die komplette Vektorsuche neu durchläuft und die Antwort von Grund auf erzeugt, fließt das Budget in bereits erledigte Arbeit.
Also habe ich einen Dienst gebaut, der nicht nur die Suche über Dokumente löst, sondern die Ersparnis sichtbar macht, in ehrlichen Zahlen.
Wie es für den Nutzer funktioniert
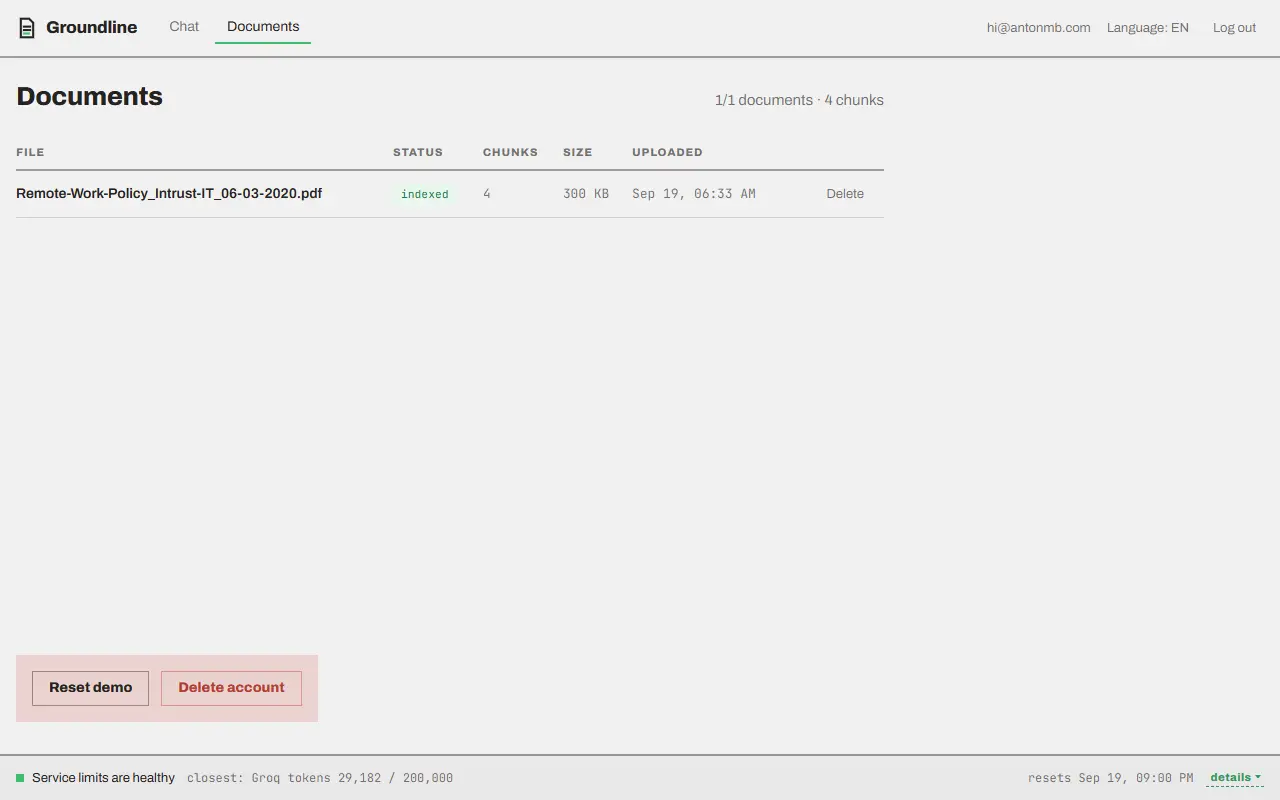
Sie laden Dokumente als PDF, TXT oder Markdown hoch und stellen Fragen. Heraus kommt eine klare Antwort mit präzisen Quellenangaben: Datei, konkreter Abschnitt und Seite. Dem Modell ist das Fantasieren strikt verboten, es arbeitet nur mit dem, was wirklich im Text gefunden wurde.
Unter der Haube: sieben Schritte einer Antwort
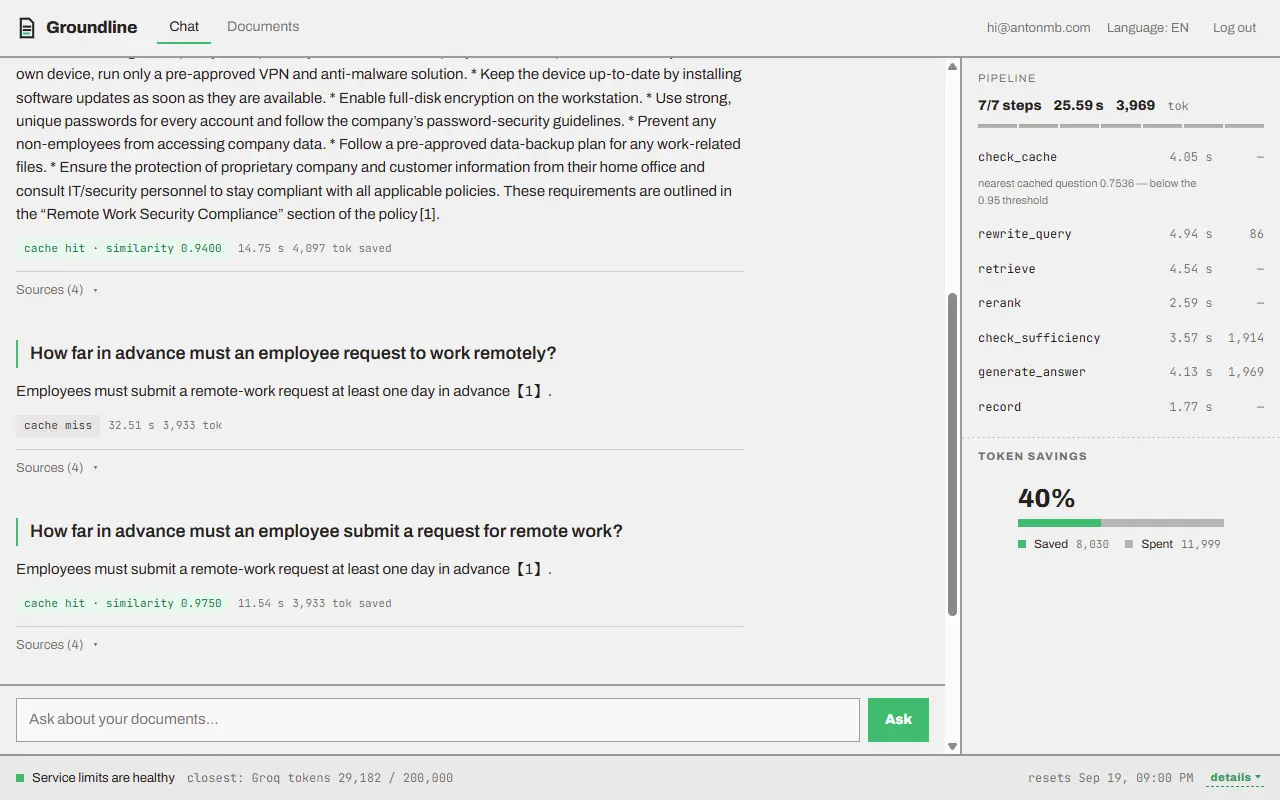
Wenn eine Frage eintrifft, rennt das System nicht sofort zum Modell, sondern durchläuft ehrlich die ganze Kette.
- Semantischer Cache. Wir prüfen, ob wir etwas Ähnliches schon beantwortet haben. Wenn ja, kommt die Antwort sofort zurück, ohne ein einziges Token zu verbrauchen.
- Umformulierung. Wenn der Cache danebenlag, räumt das Modell die Frage auf und löst Abkürzungen in eine brauchbare Suchanfrage auf.
- Hybride Suche. Vektorsuche nach Bedeutung und Volltextsuche nach exakten Wörtern laufen parallel. Die erste fängt Synonyme hervorragend ab, die zweite verliert keine speziellen Artikelnummern, Fachbegriffe und Codes.
- Neuordnung. Ein eigenes Modell bewertet die gefundenen Abschnitte und sortiert sie nicht nach formaler Ähnlichkeit, sondern danach, wie gut ein Abschnitt die Frage wirklich beantwortet.
- Selbstprüfung. Das Modell beurteilt, ob der Kontext ausreicht. Wenn nicht, startet eine weitere Suche mit dem Hinweis, was genau fehlt, höchstens zwei zusätzliche Versuche.
- Generierung. Die Antwort wird Wort für Wort an den Nutzer gestreamt.
- Speichern und Cachen. Die Antwort landet im Verlauf und im Cache für künftige ähnliche Fragen.
Der Cache, wegen dem alles begann
Die Ähnlichkeitsschwelle des Caches habe ich nicht geraten. Jede Anfrage protokolliert, wie nah sie an der nächstgelegenen gespeicherten Frage lag, auch wenn der Cache nicht griff. Anhand dieser Messwerte habe ich die Schwelle so eingestellt, dass sie echte Umformulierungen einfängt, ohne verschiedene Fragen in einen Topf zu werfen.
Auf meinem Testdatensatz mit wiederholten Fragen deckt der Cache 60 bis 65 Prozent der Anfragen ab. Bei wirklich einzigartigen Nutzerszenarien wird die Zahl natürlich niedriger liegen, der wirtschaftliche Vorteil bleibt trotzdem spürbar.
Und die Ersparnis ist schon während der Arbeit sichtbar:
- welcher Pipeline-Schritt gerade läuft und wie viele Millisekunden oder Token er verbraucht hat;
- ein Live-Diagramm der Modellkosten gegen das vom Cache gesparte Geld.
Womit ich kämpfen musste
- Kampf um den Prozessor. Die lokalen Modelle für Embeddings und Neuordnung stritten sich mit der Hintergrundindexierung neuer Dateien um die CPU. In der Spitze hing eine gewöhnliche Anfrage 83 Sekunden statt einiger Hundert Millisekunden. Gelöst durch strikte Serialisierung: Hintergrundindexierung und Fragebearbeitung warten jetzt sauber getrennt auf ihren Zugriff auf die Modelle.
- Leck bei Datenbankverbindungen. Schloss ein Nutzer den Tab mitten in der Generierung, blieb die Verbindung im Pool hängen. Auf kostenlosem Hosting mit mikroskopischem Verbindungslimit legte das den Dienst schnell lahm. Behoben, indem der finale Schreibvorgang in die Datenbank vor dem Abbruch geschützt wird.
Technischer Stack
- Backend: FastAPI, LangGraph, Python.
- Datenbank: Postgres mit der Erweiterung pgvector für die Vektorsuche, SQLAlchemy und Alembic für Migrationen.
- Sicherheit: Die Datentrennung zwischen Nutzern hängt nicht nur am Code, sondern an Row-Level Security in der Datenbank selbst. Ein vergessener Filter in einer Abfrage gibt keine fremden Dateien preis.
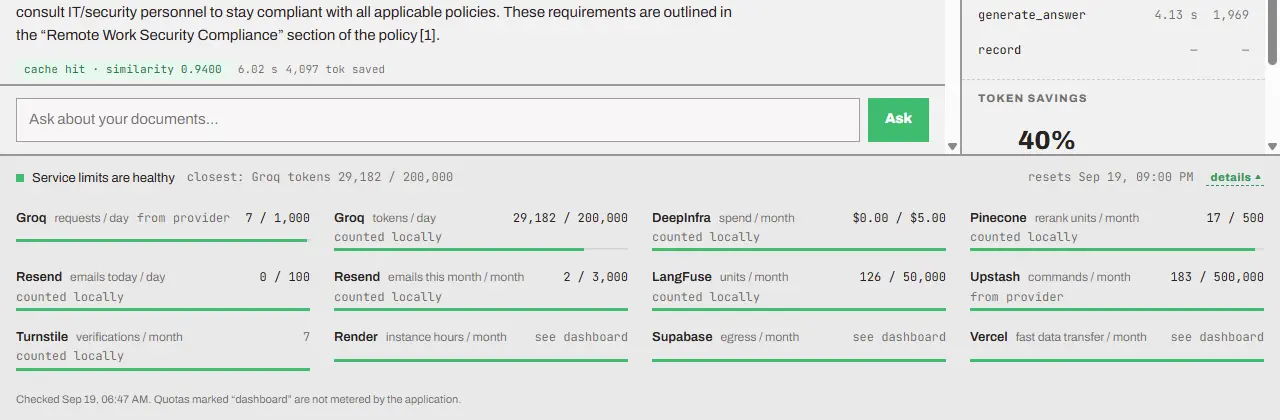
- Modelle und Monitoring: Groq für schnelle Antworten, LangFuse für das Tracing jedes Schritts, die Bibliothek ragas für die Qualitätsbewertung, inklusive Präzision, Kontextabdeckung und Abwesenheit von Halluzinationen.
Wie so eine Kette aussieht
Dieselben sieben Schritte versteht man einmal gesehen besser als gelesen. Ein interaktives Schema führt eine Anfrage durch die ganze Kette und zeigt, was sich in jeder Stufe ändert:
Wie ein Modell aus Ihren Dokumenten antwortetWo man es ausprobiert
Die Anmeldung läuft über einen Einmalcode per E-Mail, ganz ohne Passwörter. Laden Sie ein eigenes Dokument hoch oder nehmen Sie den Testkorpus, stellen Sie eine Frage und formulieren Sie sie danach um. Den Unterschied bei Tempo und Kosten sehen Sie sofort.
groundline.antonmb.com Quellcode auf GitHubÜber konstruktives Feedback und Diskussion freue ich mich, besonders von Leuten, die ähnliche Dienste schon in Produktion gebracht haben und wissen, wo diese Architektur sonst noch gern ihre Fallstricke versteckt.
Kontakt und Zusammenarbeit















































