Groundline: un servizio RAG che calcola da solo quanto denaro fa risparmiare
Un progetto personale con FastAPI e LangGraph: ricerca ibrida, riordinamento, autoverifica e una cache semantica che copre dal 60 al 65 per cento delle domande ripetute. Il risparmio si vede nell'interfaccia.
Negli ultimi giorni ho messo insieme un progetto personale chiamato Groundline e voglio raccontare perché l'ho fatto così e quali problemi risolve.
Perché un altro RAG
Costruire oggi una ricerca di base sui documenti non è un problema, i tutorial sono migliaia. Ma la maggior parte dei progetti didattici e dimostrativi si ferma alla fase «bene, qualcosa risponde». In un'azienda vera la domanda principale è un'altra: quanto costa mandarlo avanti.
Ogni chiamata a un modello linguistico costa denaro vero e secondi di attesa. Se gli utenti chiedono la stessa cosa con parole diverse e il sistema rifà ogni volta l'intera ricerca vettoriale e genera la risposta da zero, il budget se ne va in lavoro già fatto.
Ho deciso quindi di costruire un servizio che non si limita a rispondere sui documenti, ma mostra il risparmio in modo visibile, con numeri onesti.
Come funziona per l'utente
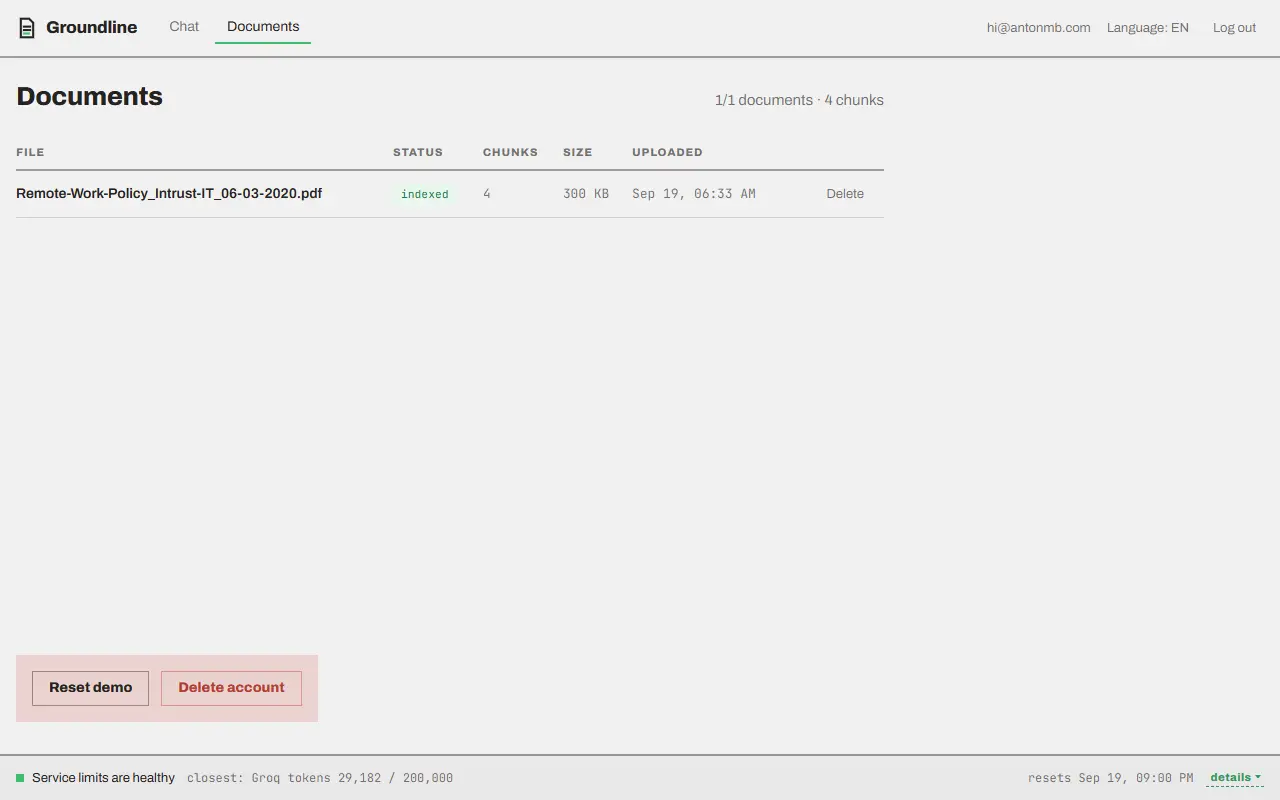
Si caricano documenti in PDF, TXT o Markdown e si fanno domande. In uscita arriva una risposta chiara con riferimenti precisi alla fonte: il file, il frammento esatto e la pagina. Al modello è severamente vietato inventare, lavora solo con quello che è stato davvero trovato nel testo.
Sotto il cofano: sette passi di una risposta
Quando arriva una domanda, il sistema non corre subito al modello, ma percorre onestamente tutta la catena.
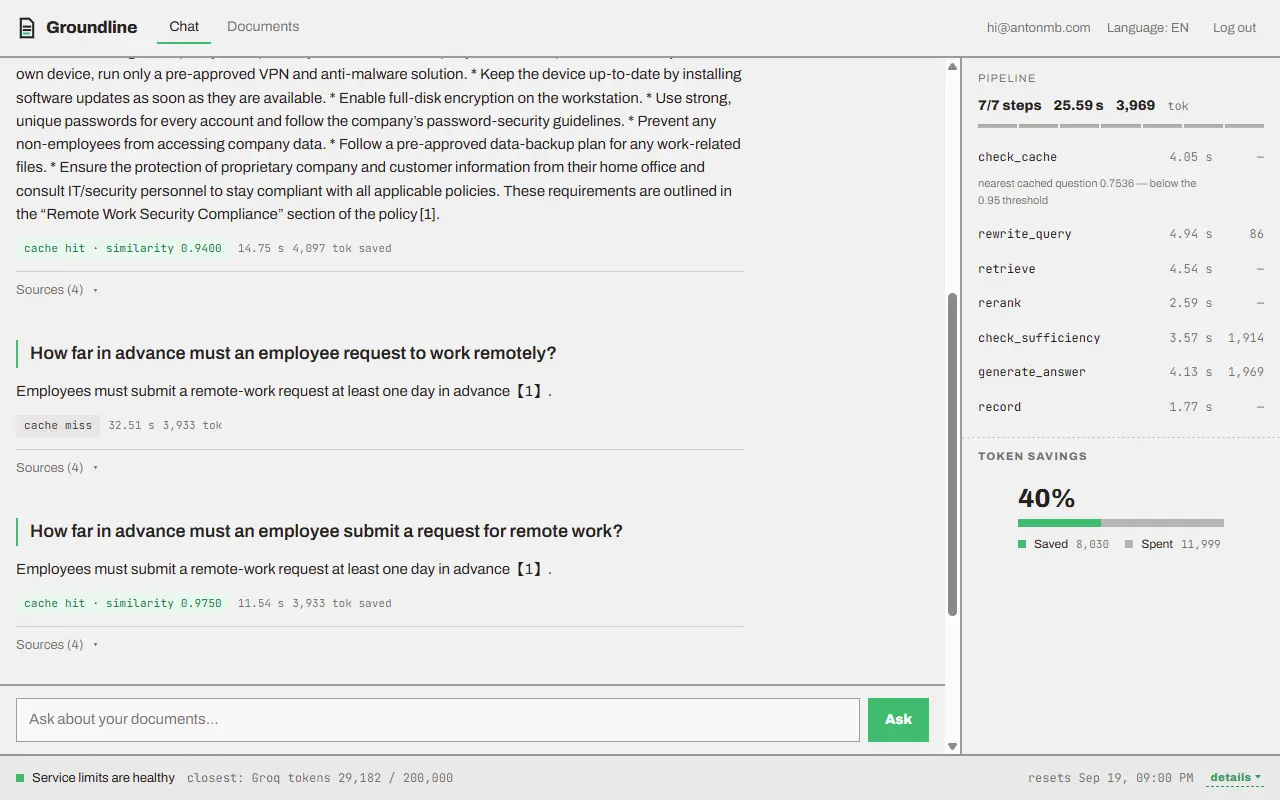
- Cache semantica. Verifichiamo se abbiamo già risposto a qualcosa di simile. Se sì, la risposta torna all'istante senza spendere un solo token.
- Riformulazione. Se la cache ha mancato il bersaglio, il modello ripulisce la domanda ed espande le abbreviazioni in una vera query di ricerca.
- Ricerca ibrida. La ricerca vettoriale per significato e quella full-text per parole esatte partono in parallelo. La prima coglie benissimo i sinonimi, la seconda non perde codici, termini e sigle specifiche.
- Riordinamento. Un modello dedicato valuta i frammenti recuperati e li riordina non per somiglianza formale, ma in base a quanto il frammento risponde davvero alla domanda.
- Autoverifica. Il modello valuta se il contesto basta. Se non basta, parte un'altra ricerca precisando cosa manca esattamente, al massimo due tentativi aggiuntivi.
- Generazione. La risposta viene trasmessa all'utente parola per parola.
- Salvataggio e cache. La risposta finisce nella cronologia e nella cache per le future domande simili.
La cache per cui è nato tutto
La soglia di somiglianza della cache non l'ho tirata a caso. Ogni richiesta registra quanto era vicina alla domanda salvata più prossima, anche quando la cache non è scattata. Su quelle metriche ho tarato la soglia in modo da catturare le riformulazioni vere senza buttare domande diverse nello stesso mucchio.
Sul mio set di prova con domande ripetute la cache copre dal 60 al 65 per cento delle richieste. Su scenari utente davvero unici il numero sarà ovviamente più basso, ma il vantaggio economico resta percepibile.
E il risparmio si vede mentre il servizio lavora:
- quale passo della pipeline è in corso adesso e quanti millisecondi o token ha consumato;
- un grafico in tempo reale della spesa per il modello contro il denaro risparmiato dalla cache.
Contro cosa ho dovuto combattere
- Contesa per il processore. I modelli locali per gli embedding e il riordinamento si contendevano la CPU con l'indicizzazione in background dei nuovi file. Nel picco una richiesta ordinaria restava appesa 83 secondi invece di poche centinaia di millisecondi. Risolto con una serializzazione rigida: indicizzazione di fondo ed elaborazione delle domande ora aspettano ciascuna il proprio turno per accedere ai modelli.
- Perdita di connessioni al database. Se l'utente chiudeva la scheda proprio durante la generazione, la connessione restava incastrata nel pool. Su un hosting gratuito con un limite di connessioni microscopico questo faceva cadere il servizio in fretta. Risolto proteggendo dalla cancellazione la scrittura finale sul database.
Stack tecnico
- Backend: FastAPI, LangGraph, Python.
- Database: Postgres con l'estensione pgvector per la ricerca vettoriale, SQLAlchemy e Alembic per le migrazioni.
- Sicurezza: l'isolamento dei dati tra utenti non dipende solo dal codice ma dalla Row-Level Security nel database stesso. Un filtro dimenticato in una query non farà uscire i file altrui.
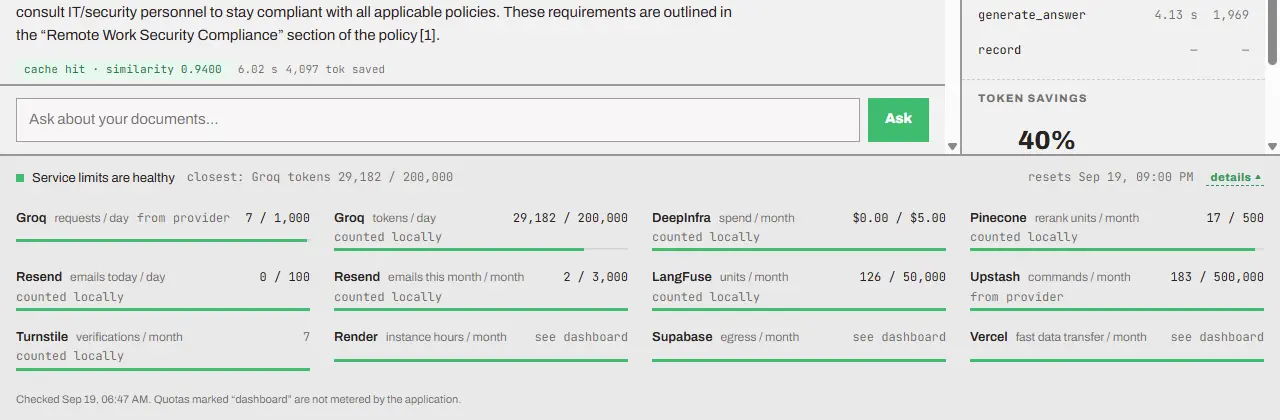
- Modelli e monitoraggio: Groq per le risposte veloci, LangFuse per tracciare ogni passo, la libreria ragas per valutare la qualità, inclusi precisione, copertura del contesto e assenza di allucinazioni.
Che aspetto ha una catena del genere
Quegli stessi sette passi si capiscono meglio vedendoli una volta che leggendoli. Uno schema interattivo porta una richiesta lungo tutta la catena e mostra cosa cambia a ogni stadio:
Come un modello risponde partendo dai tuoi documentiDove provarlo
L'accesso avviene con un codice monouso inviato via email, senza password. Caricate un vostro documento oppure prendete il corpus di prova, fate una domanda e poi riformulatela. La differenza di velocità e di costo si vede subito.
groundline.antonmb.com Codice sorgente su GitHubSarò contento di ricevere commenti costruttivi e discussione, soprattutto da chi ha già portato servizi simili in produzione e sa dove questa architettura ama ancora nascondere i suoi rastrelli.
Contatti e collaborazione















































