Groundline: RAG-сервис, который сам считает, сколько денег сэкономил
Пет-проект на FastAPI и LangGraph: гибридный поиск, переранжирование, самопроверка и семантический кэш, который закрывает от 60 до 65 процентов повторных вопросов. Экономия видна прямо в интерфейсе.
За последние несколько дней я собрал пет-проект под названием Groundline и хочу поделиться, почему сделал его именно таким и какие задачи он решает.
Зачем ещё один RAG
Сделать базовый поиск по документам сейчас не проблема, ведь туториалов тысячи. Но большинство учебных и демонстрационных проектов останавливаются на стадии «ура, оно как-то отвечает». В реальном бизнесе главный вопрос другой: сколько стоит это эксплуатировать.
Каждый запрос к языковым моделям стоит живых денег и секунд ожидания. Если пользователи часто спрашивают одно и то же разными словами, а система каждый раз заново прогоняет полный векторный поиск и генерирует ответ с нуля, бюджет расходуется на повторную работу.
Я решил построить сервис, который не просто закрывает задачи поиска по документам, но и показывает экономию наглядно, в честных цифрах.
Как это работает для пользователя
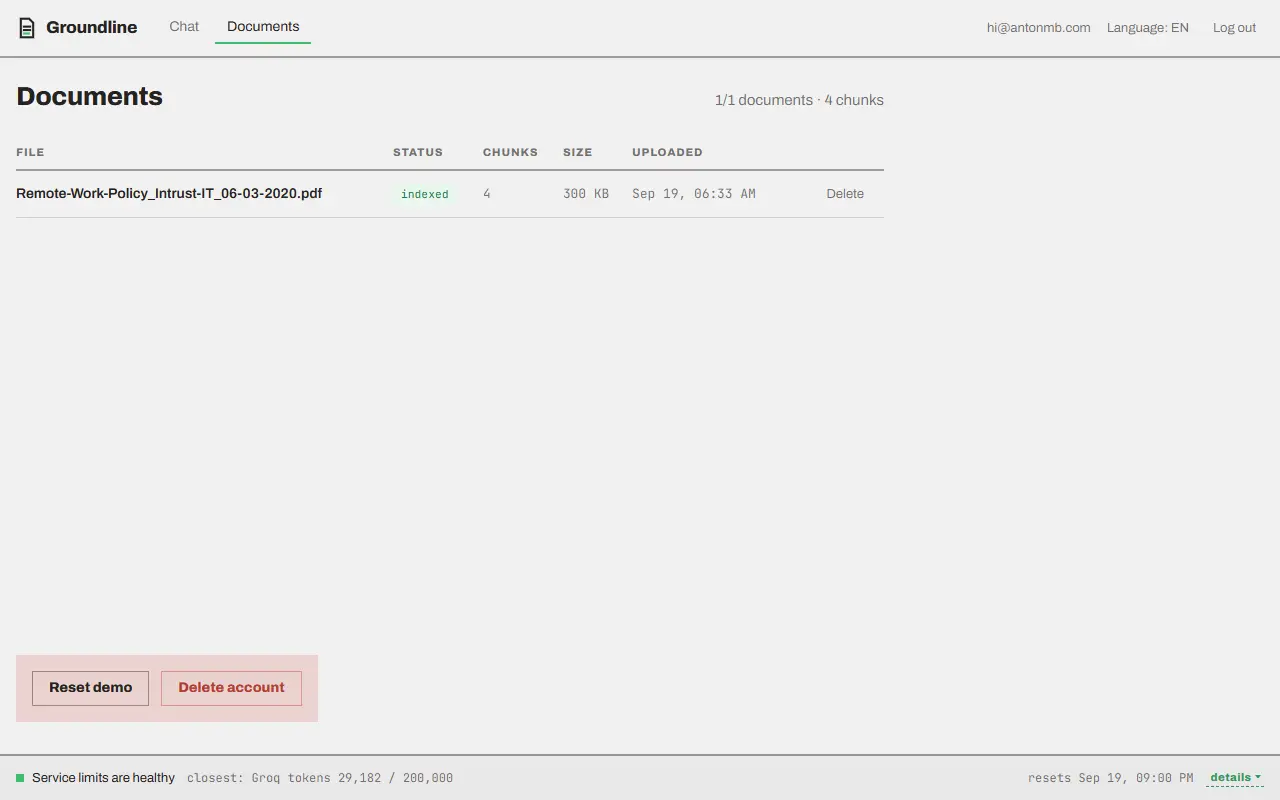
Загружаете документы в форматах PDF, TXT или Markdown и задаёте вопросы. На выходе получаете чёткий ответ с точными ссылками на источник: файл, конкретный фрагмент и страницу. Модели строго запрещено фантазировать, она работает только с тем, что реально найдено в тексте.
Под капотом: семь шагов одного ответа
Когда приходит вопрос, система не бежит сразу к модели, а честно прогоняет цепочку.
- Семантический кэш. Проверяем, не отвечали ли мы уже на нечто подобное. Если да, отдаём ответ мгновенно, не потратив ни одного токена.
- Переформулировка. Если кэш промазал, модель чистит вопрос от мусора и разворачивает сокращения в нормальный поисковый запрос.
- Гибридный поиск. Запускаем параллельно векторный поиск по смыслу и полнотекстовый по точным словам. Первый отлично ловит синонимы, второй не теряет специфические артикулы, термины и коды.
- Переранжирование. Специальная модель оценивает найденные куски и пересортировывает их не просто по формальной похожести, а по тому, насколько фрагмент реально отвечает на вопрос.
- Самопроверка. Модель оценивает, достаточно ли контекста. Если нет, запускается повторный поиск с уточнением, чего именно не хватает, максимум две дополнительные попытки.
- Генерация. Ответ стримится пользователю слово за словом.
- Сохранение и кэширование. Ответ записывается в историю и отправляется в кэш для будущих похожих вопросов.
Кэш, ради которого всё затевалось
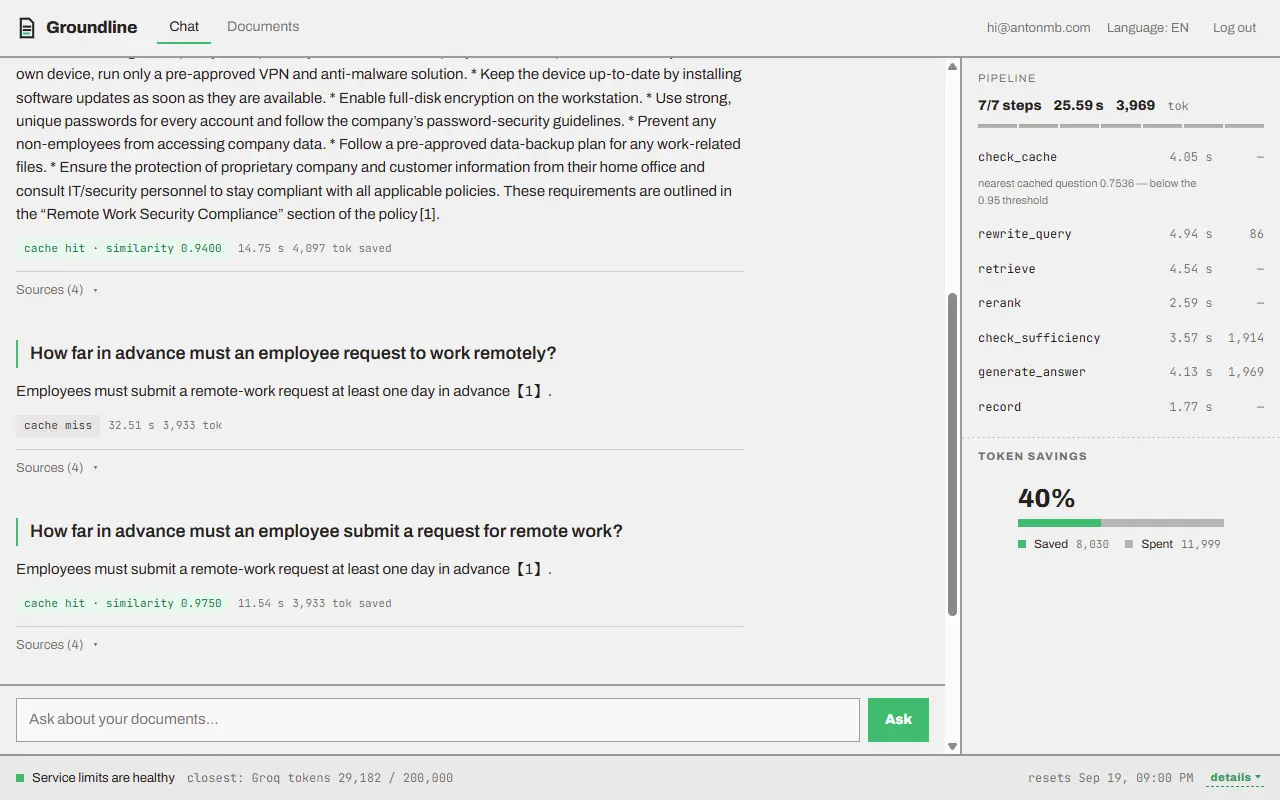
Порог похожести для кэша я не брал с потолка. Каждый запрос логирует степень сходства с ближайшим сохранённым вопросом, даже если кэш не сработал. На основе этих метрик я подобрал порог так, чтобы забирать реальные перефразировки, но не сваливать разные вопросы в одну кучу.
На моём тестовом наборе данных с повторяющимися вопросами кэш успешно закрывает от 60 до 65 процентов запросов. Разумеется, на уникальных пользовательских сценариях эта цифра будет ниже, но экономическая выгода всё равно ощутима.
Причём экономия видна прямо в процессе работы:
- какой шаг пайплайна идёт прямо сейчас и сколько миллисекунд или токенов он съел;
- живой график затрат на модель против сэкономленных кэшем денег.
С чем пришлось повоевать
- Конфликт за процессор. Локальные модели для эмбеддингов и реранкинга вместе с фоновой индексацией новых файлов активно делили процессор. В пике один обычный запрос вместо сотен миллисекунд висел 83 секунды. Решил жёсткой сериализацией: фоновая индексация и обработка вопросов теперь строго разведены и ждут своей очереди к моделям.
- Утечка соединений с базой данных. Если пользователь закрывал вкладку прямо во время генерации ответа, коннект к базе залипал в пуле. На бесплатном хостинге с микроскопическим лимитом соединений это быстро приводило к падающему сервису. Починил через защиту финальной операции записи в базу данных от отмены.
Технический стек
- Backend: FastAPI, LangGraph, Python.
- База данных: Postgres с расширением pgvector для векторного поиска, SQLAlchemy и Alembic для миграций.
- Безопасность: изоляция данных между пользователями завязана не только на код, но и на Row-Level Security прямо в базе данных. Забытый фильтр в запросе не сольёт чужие файлы.
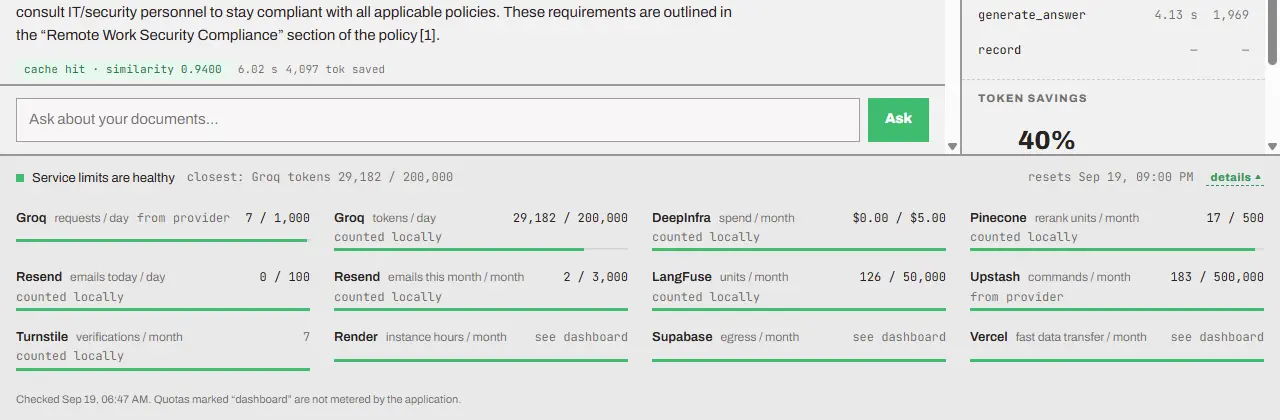
- Модели и мониторинг: Groq для быстрых ответов, LangFuse для трейсинга каждого шага, библиотека ragas для оценки качества, включая точность, полноту контекста и отсутствие галлюцинаций.
Как выглядит такая цепочка
Те же семь шагов удобнее один раз увидеть, чем прочитать. Интерактивная схема проводит запрос по всей цепочке и показывает, что меняется на каждом этапе:
Как модель отвечает по вашим документамГде пощупать
Вход по одноразовому коду на почту, без паролей. Загрузите свой документ или возьмите тестовый корпус, задайте вопрос, а затем перефразируйте его. Разницу в скорости и стоимости увидите сразу.
groundline.antonmb.com Исходный код на GitHubБуду рад конструктивному фидбеку и дискуссии, особенно от тех, кто уже запускал аналогичные сервисы в продакшн и знает, где ещё в такой архитектуре любят прятаться грабли.
Контакты и сотрудничество















































