Groundline: 절약한 비용을 스스로 계산하는 RAG 서비스
FastAPI와 LangGraph로 만든 개인 프로젝트. 하이브리드 검색, 재순위화, 자체 점검, 그리고 반복 질문의 60에서 65 퍼센트를 처리하는 시맨틱 캐시. 절약액은 화면에서 바로 보입니다.
최근 며칠 동안 Groundline이라는 개인 프로젝트를 만들었습니다. 왜 이런 형태로 만들었는지, 어떤 문제를 푸는지 이야기하려 합니다.
왜 또 하나의 RAG인가
문서 검색의 기본형을 만드는 일은 이제 어렵지 않습니다. 튜토리얼이 수천 개나 있으니까요. 하지만 학습용이나 시연용 프로젝트 대부분은 「오, 어쨌든 답을 하네」 단계에서 멈춥니다. 실제 비즈니스에서 중요한 질문은 다릅니다. 운영 비용이 얼마나 드는가입니다.
언어 모델을 호출할 때마다 실제 돈과 대기 시간이 듭니다. 사용자가 같은 내용을 다른 표현으로 자주 묻는데 시스템이 매번 전체 벡터 검색을 다시 돌리고 답을 처음부터 생성한다면, 예산은 이미 한 일을 반복하는 데 쓰입니다.
그래서 문서 검색만 해결하는 것이 아니라, 절약한 금액을 정직한 숫자로 보여 주는 서비스를 만들기로 했습니다.
사용자 입장에서의 동작
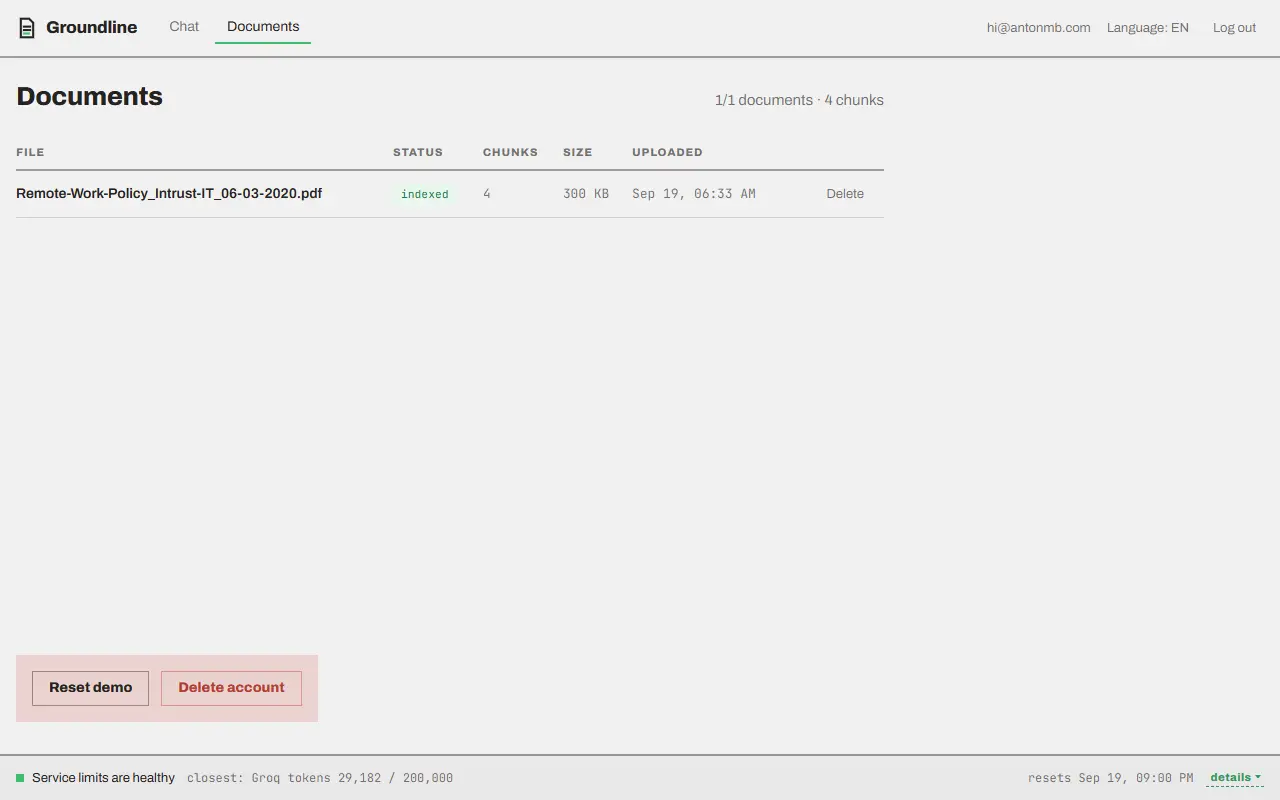
PDF, TXT, Markdown 형식의 문서를 올리고 질문합니다. 결과로 출처를 정확히 짚은 명확한 답변이 나옵니다. 파일, 해당 조각, 페이지까지 표시됩니다. 모델에는 지어내기가 엄격히 금지되어 있으며, 본문에서 실제로 찾은 내용만 사용합니다.
내부 구조: 하나의 답변을 만드는 일곱 단계
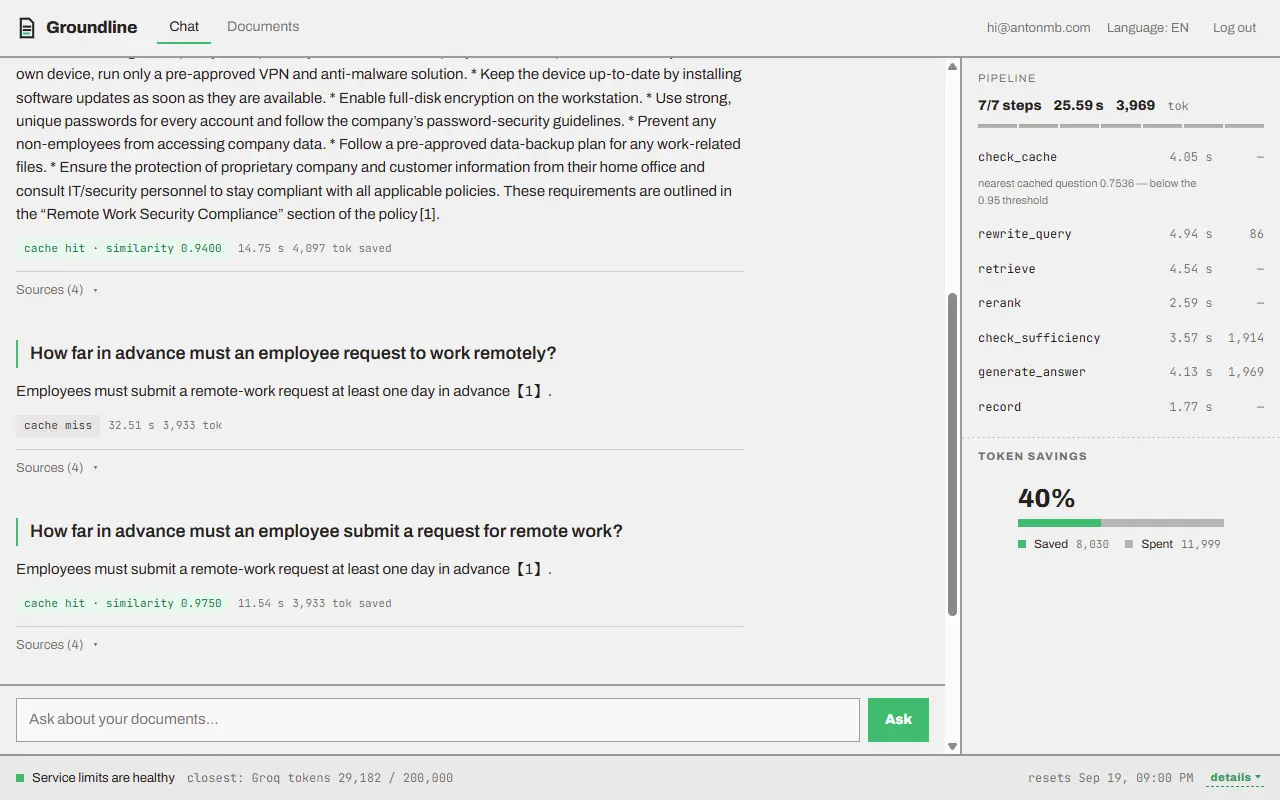
질문이 들어오면 시스템은 곧장 모델로 달려가지 않고, 체인 전체를 성실하게 지나갑니다.
- 시맨틱 캐시. 비슷한 질문에 이미 답했는지 확인합니다. 그렇다면 토큰을 한 개도 쓰지 않고 즉시 답을 돌려줍니다.
- 재작성. 캐시가 빗나가면 모델이 질문에서 군더더기를 걷어내고 약어를 풀어 제대로 된 검색 질의로 만듭니다.
- 하이브리드 검색. 의미 기반 벡터 검색과 정확한 단어 기반 전문 검색을 동시에 돌립니다. 앞쪽은 동의어를 잘 잡고, 뒤쪽은 품번이나 전문 용어, 코드를 놓치지 않습니다.
- 재순위화. 전용 모델이 검색된 조각들을 평가해, 형식적인 유사도가 아니라 그 조각이 실제로 질문에 얼마나 답하는지를 기준으로 다시 정렬합니다.
- 자체 점검. 모델이 문맥이 충분한지 판단합니다. 부족하면 무엇이 빠졌는지 명시해 다시 검색하며, 추가 시도는 최대 두 번입니다.
- 생성. 답변은 사용자에게 한 단어씩 스트리밍됩니다.
- 저장과 캐싱. 답변은 기록에 남고, 앞으로의 비슷한 질문을 위해 캐시로 들어갑니다.
애초에 목표였던 캐시
캐시의 유사도 임계값은 감으로 정한 것이 아닙니다. 캐시가 작동하지 않은 경우까지 포함해, 모든 요청이 가장 가까운 저장된 질문과의 유사도를 기록합니다. 그 지표를 바탕으로, 진짜 재표현은 잡되 서로 다른 질문을 한데 묶지는 않도록 임계값을 맞췄습니다.
반복 질문이 포함된 제 테스트 데이터에서는 캐시가 요청의 60에서 65 퍼센트를 처리합니다. 완전히 고유한 사용 시나리오에서는 당연히 이 수치가 낮아지지만, 경제적 이득은 여전히 뚜렷합니다.
게다가 절약되는 과정이 작동 중에 그대로 보입니다.
- 지금 파이프라인의 어느 단계가 돌고 있으며 몇 밀리초 또는 몇 토큰을 썼는지.
- 모델 지출과 캐시가 아낀 금액을 나란히 보여 주는 실시간 그래프.
씨름해야 했던 문제
- CPU 경합. 임베딩과 재순위화를 맡은 로컬 모델이 새 파일의 백그라운드 색인 작업과 프로세서를 두고 심하게 다퉜습니다. 최악의 순간에는 평범한 요청 하나가 수백 밀리초가 아니라 83초 동안 매달려 있었습니다. 엄격한 직렬화로 해결했습니다. 백그라운드 색인과 질문 처리가 완전히 분리되어 모델 접근 순서를 기다립니다.
- 데이터베이스 커넥션 누수. 답변 생성 도중에 사용자가 탭을 닫으면 커넥션이 풀에 붙잡힌 채 남았습니다. 커넥션 한도가 극히 작은 무료 호스팅에서는 이것만으로 서비스가 금방 멈췄습니다. 데이터베이스에 대한 마지막 쓰기 작업을 취소로부터 보호해 해결했습니다.
기술 스택
- 백엔드: FastAPI, LangGraph, Python.
- 데이터베이스: 벡터 검색을 위한 pgvector 확장을 올린 Postgres, 마이그레이션에는 SQLAlchemy와 Alembic.
- 보안: 사용자 간 데이터 격리는 코드뿐 아니라 데이터베이스 안의 Row-Level Security에도 묶여 있습니다. 쿼리에서 필터를 빠뜨려도 남의 파일이 새지 않습니다.
- 모델과 모니터링: 빠른 답변에는 Groq, 각 단계 추적에는 LangFuse, 품질 평가에는 ragas 라이브러리를 사용해 정확도, 문맥 재현율, 환각 여부를 측정합니다.
이런 체인은 어떻게 생겼나
같은 일곱 단계는 읽는 것보다 한 번 보는 편이 빠릅니다. 대화형 도식이 질의를 체인 전체로 통과시키며 각 단계에서 무엇이 달라지는지 보여 줍니다.
모델은 당신의 문서로 어떻게 답하는가직접 써 볼 곳
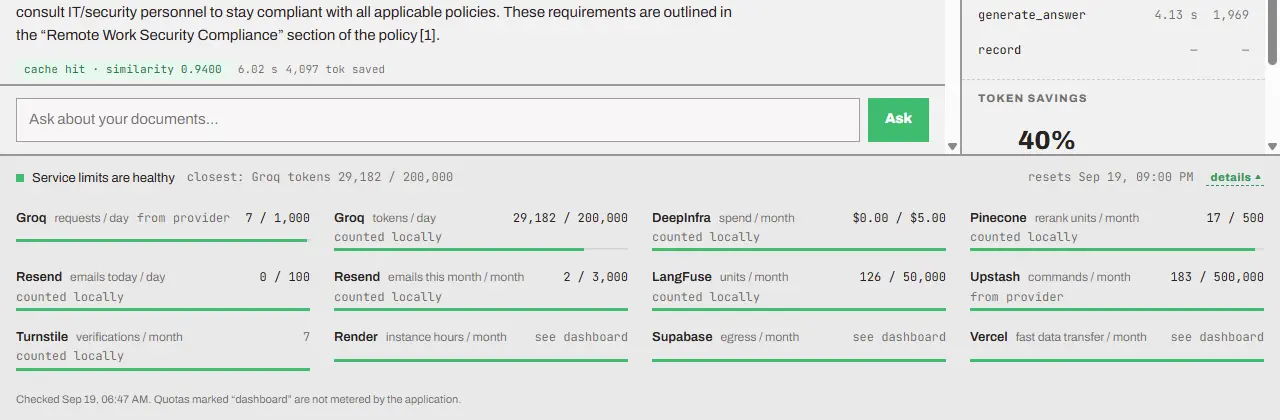
로그인은 이메일로 받는 일회용 코드만 쓰며 비밀번호는 없습니다. 자기 문서를 올리거나 테스트 코퍼스를 써서 질문한 뒤, 같은 내용을 다르게 표현해 보세요. 속도와 비용의 차이가 바로 보입니다.
groundline.antonmb.com GitHub 소스 코드건설적인 피드백과 토론을 환영합니다. 특히 비슷한 서비스를 이미 프로덕션에 올려 보고, 이런 구조가 또 어디에 함정을 숨겨 두는지 아는 분들의 이야기를 듣고 싶습니다.
연락처와 협업















































