Wie ich versehentlich ein LLM-Orchestrierungssystem im Browser gebaut habe
Ein architektonischer Blick darauf, wie Litseller die GPT-API, React, Prompts und Orchestrierung im Browser nutzte, um strukturierte Inhalte für einen Buchkatalog zu erzeugen.
Vor zwei Jahren habe ich Litseller gebaut.
Damals dachte ich weder an LLM-Orchestrierung noch an die Architektur solcher Systeme. Ich löste einfach ein konkretes Problem: wie sich schnell strukturierte Inhalte für einen Buchkatalog erzeugen lassen.
Im Rückblick verstehe ich, dass es im Kern ein vollständiges LLM-Orchestrierungssystem war. Nur eben nicht im Backend umgesetzt, sondern direkt im Browser.
Was es tatsächlich war
Es ist wichtig, das richtig einzuordnen.
Litseller war kein LLM-Dienst.
Es war eine klassische Webanwendung mit einem Katalog, in die ich ein LLM als Werkzeug zur Datengenerierung im Adminbereich eingebettet habe.
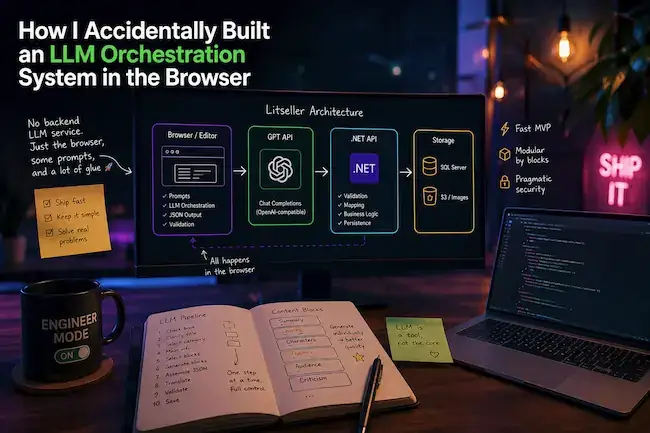
Die gesamte Orchestrierung lief in einem einfachen Ablauf: Editor-UI, GPT-API, JSON, Validierung, Speichern im Backend.
- Keine Queues.
- Keine Worker.
- Keine serverseitige Orchestrierung.
- Keine komplexe Infrastruktur.
Alles beruhte auf React, Prompts und Ketten von Anfragen.
Architektur
Das System war in drei Schichten aufgeteilt.
- Frontend: Next.js-Adminbereich, Editor und die gesamte LLM-Logik.
- Backend: .NET-API, Validierung und Persistenz.
- Speicher: SQL Server und S3.
Die LLM-Logik lag überhaupt nicht im Backend. Die Aufrufe gingen direkt aus dem Browser.
Generierungs-Pipeline
Statt einer großen Anfrage baute ich eine Pipeline.
- Prüfen, ob das Modell das Buch kennt.
- Bei Bedarf den Titel klären.
- Eine Kategorie wählen.
- Die Hauptinformationen erzeugen.
- Inhaltsblöcke auswählen, etwa Zusammenfassung, Zitate, Themen und weitere Abschnitte.
- Jeden Block einzeln erzeugen.
- Das JSON zusammensetzen.
- Den Inhalt in andere Sprachen übersetzen.
- Das Ergebnis validieren.
- Die finalen Daten speichern.
Das war bereits echte Orchestrierung, nur eben ohne eigenen Orchestrierungsdienst.
Warum Blöcke gut funktionierten
Inhalte blockweise zu erzeugen war eine der stärksten Entscheidungen.
Ich bat das Modell nicht, die gesamte Buchseite auf einmal zu erzeugen.
- Die Zusammenfassung wurde separat erzeugt.
- Die Figuren wurden separat erzeugt.
- Die Zitate wurden separat erzeugt.
- Die Themen wurden separat erzeugt.
Das gab mir bessere Qualitätskontrolle, die Möglichkeit, einzelne Teile neu zu erzeugen, stabileres JSON und weniger Fehler.
In der Praxis wurde daraus eine manuelle Versionskontrollschicht über der LLM-Ausgabe.
Prompt Engineering
Die Prompts waren einfach, aber strukturiert.
- Striktes JSON-Format.
- Klare Anweisungen.
- Minimale Magie.
Der Kontext wurde explizit übergeben: Titel, Autor, Kategorien, Sprache und vorherige Blöcke.
- Kein Gesprächsgedächtnis.
- Kein komplexer Zustand.
- Kein Tool Calling.
Die umstrittenste Entscheidung
Der API-Schlüssel lag im localStorage.
Der Grund war einfach: Der Editor war keine öffentliche Oberfläche, es gab sehr wenige Nutzer, Priorität hatte ein schneller Start, und Backend-Orchestrierung hätte das System deutlich komplexer gemacht.
Das war eine bewusste Entscheidung. Die Risiken waren verstanden und akzeptiert.
Zusätzlich war der Zugang eingeschränkt und manuell über Cloudflare geschützt.
Schwachstellen
Ehrlich betrachtet sind die Schwachstellen heute offensichtlich.
- API-Schlüssel auf dem Client.
- Kein zentrales Rate Limiting.
- Keine zentrale Kontrolle der Aufrufe.
- Kein Retry- oder Backoff-Mechanismus.
- Keine ordentliche Schema-Validierung.
- Schwache Fehlerbehandlung.
- Keine Observability.
- Zu viel komplexe Logik im Browser.
Es war ein starkes MVP, aber keine produktionsreife LLM-Plattform.
Stärken
Gleichzeitig funktionierte das System und lieferte echte Ergebnisse.
- Sehr schnelle Entwicklung.
- Minimale Infrastruktur.
- Hohe Flexibilität.
- Volle Kontrolle über die Oberfläche.
- Bequeme manuelle Nacharbeit.
- Modulare Generierung.
- Echter Produktionsablauf.
Das LLM war ein Werkzeug, nicht der Kern des Systems.
Was ich heute anders machen würde
Würde ich es heute noch einmal bauen, würde ich die Architektur ändern.
- LLM-Aufrufe in ein Backend-Gateway verlagern.
- Den API-Schlüssel vom Client entfernen.
- Queues und Retries ergänzen.
- Strikte JSON-Schema-Validierung einführen.
- Logging und Tracing hinzufügen.
- Rate Limiting umsetzen.
- Orchestrierung von der Oberfläche trennen.
Die wichtigste Erkenntnis
Das Interessanteste daran ist für mich, dass ich kein LLM-System entworfen habe.
Ich habe einfach ein Problem gelöst.
Erst später wurde mir klar, dass ich eine Architektur gebaut hatte, die man heute LLM-Orchestrierung nennt.
Manchmal sehen gute Engineering-Entscheidungen zuerst wie Chaos und Intuition aus. Erst später werden sie zu einer klaren Architektur, die man bewusst verbessern kann.
Was im Modell passiert
Alles oben ist Orchestrierung um ein Modell herum, das bereits funktioniert. Eine interaktive Seite nimmt die andere Seite: Ein Regler führt das Modell durch tausend Trainingsschritte, von Zufallszahlen bis zur Vorhersage.
Wie ein Sprachmodell lernt: interaktives Schema