Groundline: 節約した金額を自分で数える RAG サービス
FastAPI と LangGraph で作った個人プロジェクト。ハイブリッド検索、リランキング、自己検証、そして繰り返しの質問の 60 から 65 パーセントを処理するセマンティックキャッシュ。節約額は画面上でそのまま見えます。
ここ数日で Groundline という個人プロジェクトを作りました。なぜこういう形にしたのか、どんな課題を解くのかを紹介します。
なぜもう一つ RAG を作るのか
文書検索の基本形を作ること自体は、いまや難しくありません。チュートリアルは何千とあります。しかし学習用やデモ用のプロジェクトの多くは「おお、とりあえず答えた」という段階で止まります。実際のビジネスで問われるのは別のことです。運用にいくらかかるのか、という点です。
言語モデルへのリクエストは、そのたびに実際のお金と待ち時間を消費します。利用者が同じ内容を違う言い回しで何度も尋ね、そのたびにシステムがベクトル検索を最初からやり直して回答を生成していれば、予算は済んだはずの作業の繰り返しに消えていきます。
そこで、文書検索を解くだけでなく、節約できた分を正直な数字で見せるサービスを作ることにしました。
利用者から見た動き
PDF、TXT、Markdown の文書をアップロードして質問します。返ってくるのは、出典への正確な参照が付いた明確な回答です。ファイル、該当する断片、ページまで示されます。モデルには創作が厳しく禁じられており、本文中に実際に見つかったものだけを使います。
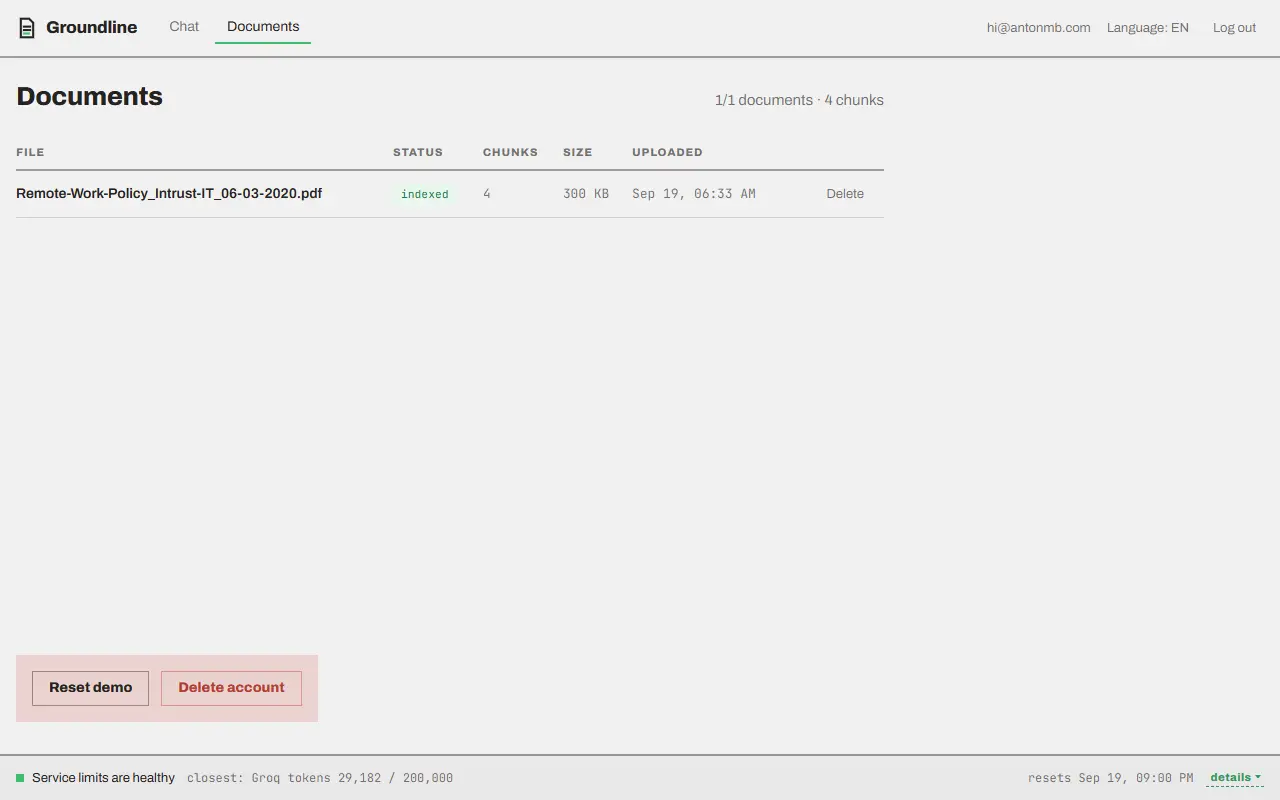
内部構造: 一つの回答に至る七つの手順
質問が届いたとき、システムはすぐモデルに走るのではなく、律儀にチェーン全体をたどります。
- セマンティックキャッシュ。似た質問にすでに答えていないかを確認します。あれば、トークンを一つも使わずに即座に回答を返します。
- 言い換え。キャッシュが外れた場合、モデルが質問から余計な部分を取り除き、略語を展開して検索に適した形にします。
- ハイブリッド検索。意味によるベクトル検索と、正確な語による全文検索を並行して走らせます。前者は同義語をよく拾い、後者は品番や専門用語、コードを取りこぼしません。
- リランキング。専用のモデルが取得した断片を評価し、形式的な類似度ではなく、その断片が実際にどれだけ質問に答えているかで並べ替えます。
- 自己検証。文脈が十分かどうかをモデルが判定します。不足していれば、何が足りないかを明示して再検索を走らせます。追加の試行は最大二回までです。
- 生成。回答は一語ずつ利用者にストリーミングされます。
- 保存とキャッシュ。回答は履歴に記録され、今後の類似した質問のためにキャッシュへ送られます。
そもそもの目的だったキャッシュ
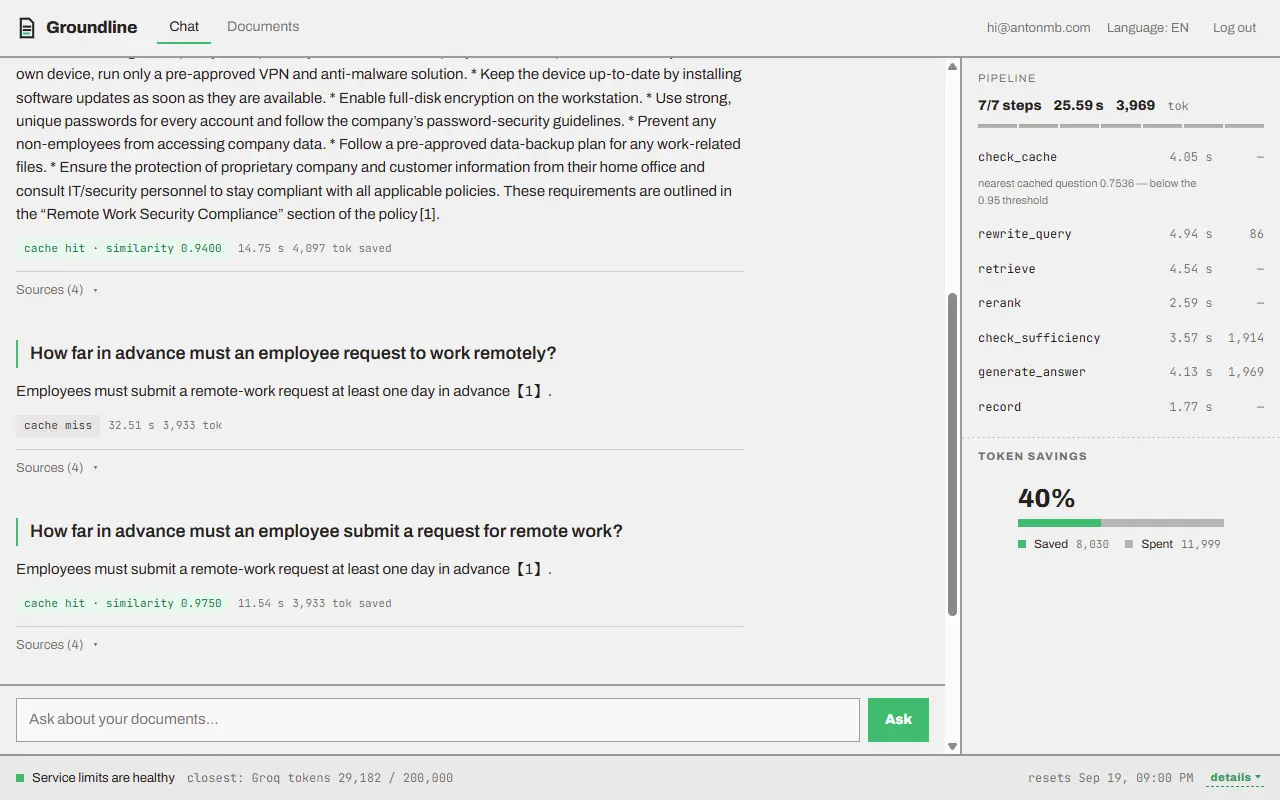
キャッシュの類似度しきい値は当てずっぽうで決めたものではありません。キャッシュが効かなかった場合も含め、すべてのリクエストが最も近い保存済みの質問との類似度を記録します。その計測値をもとに、本当の言い換えは拾い、異なる質問はひとまとめにしないところへしきい値を合わせました。
繰り返しの質問を含む私のテストデータでは、キャッシュがリクエストの 60 から 65 パーセントを処理します。本当に一度きりの利用場面ではこの数字は下がりますが、経済的な効果は依然としてはっきり出ます。
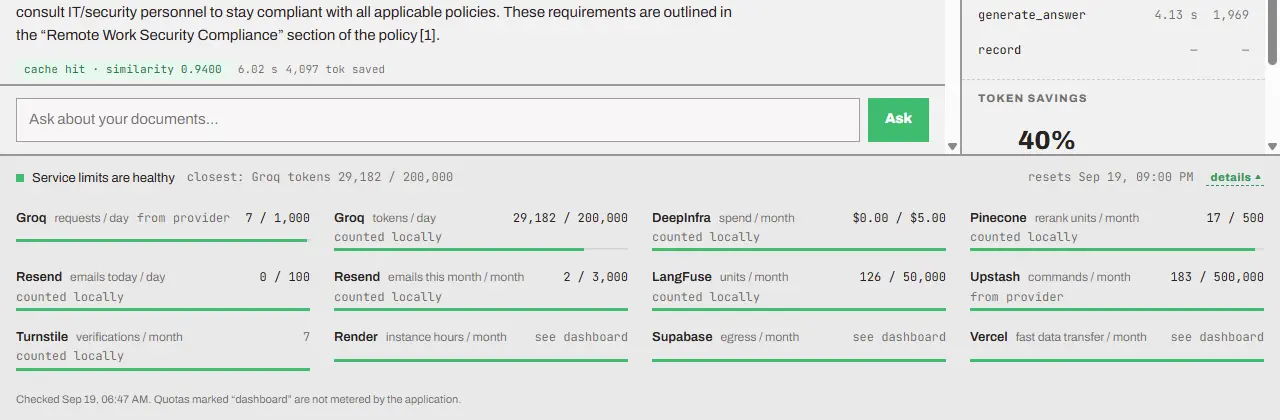
しかも節約の様子は動作中にそのまま見えます。
- パイプラインのどの手順がいま動いていて、何ミリ秒あるいは何トークンを消費したか。
- モデルにかかった費用と、キャッシュが節約した金額を並べたリアルタイムのグラフ。
苦労した点
- CPU の奪い合い。埋め込みとリランキングのローカルモデルが、新しいファイルのバックグラウンド索引作成と激しく CPU を取り合いました。ピーク時には通常のリクエストが数百ミリ秒ではなく 83 秒かかりました。厳格な直列化で解決しています。背景の索引作成と質問処理は完全に分離され、モデルへの順番を待つようになりました。
- データベース接続のリーク。回答の生成中に利用者がタブを閉じると、接続がプールに残ったままになりました。接続数の上限が極端に小さい無料ホスティングでは、これがすぐにサービス停止につながります。データベースへの最終書き込みをキャンセルから保護することで修正しました。
技術スタック
- バックエンド: FastAPI、LangGraph、Python。
- データベース: ベクトル検索のための pgvector 拡張を入れた Postgres、マイグレーションには SQLAlchemy と Alembic。
- セキュリティ: 利用者間のデータ分離はコードだけでなく、データベース内の Row-Level Security にも支えられています。クエリでフィルタを書き忘れても他人のファイルは漏れません。
- モデルと監視: 高速な回答には Groq、各手順のトレースには LangFuse、品質評価には ragas ライブラリを使い、精度、文脈の網羅、幻覚の有無を測ります。
このチェーンを目で見る
同じ七つの手順は、読むより一度見たほうが早く飲み込めます。対話型の図はクエリをチェーン全体に通し、各段階で何が変わるかを示します。
モデルはあなたの文書からどう答えるのか試せる場所
ログインはメールに届く使い捨てコードのみで、パスワードはありません。自分の文書をアップロードするか、テスト用のコーパスを使って質問し、そのあと言い換えてみてください。速度と費用の違いはすぐに分かります。
groundline.antonmb.com GitHub のソースコード建設的な意見や議論を歓迎します。特に、似たサービスをすでに本番投入し、この種のアーキテクチャがどこに落とし穴を隠しているかを知っている方からの声を待っています。
連絡先と協業について















































