Groundline: um serviço RAG que calcula quanto dinheiro economiza
Um projeto pessoal em FastAPI e LangGraph: busca híbrida, reordenação, autoverificação e um cache semântico que cobre de 60 a 65 por cento das perguntas repetidas. A economia aparece na própria interface.
Nos últimos dias montei um projeto pessoal chamado Groundline e quero contar por que o fiz assim e quais problemas ele resolve.
Por que mais um RAG
Montar uma busca básica sobre documentos hoje não é problema, existem milhares de tutoriais. Mas a maioria dos projetos de estudo e de demonstração para no estágio de «ótimo, ele responde alguma coisa». Num negócio real a pergunta principal é outra: quanto custa operar isso.
Cada chamada a um modelo de linguagem custa dinheiro real e segundos de espera. Se os usuários perguntam a mesma coisa com palavras diferentes e o sistema refaz a busca vetorial completa e gera a resposta do zero toda vez, o orçamento vai embora repetindo trabalho já feito.
Resolvi construir um serviço que não apenas resolve a busca sobre documentos, mas também mostra a economia de forma visível, em números honestos.
Como funciona para o usuário
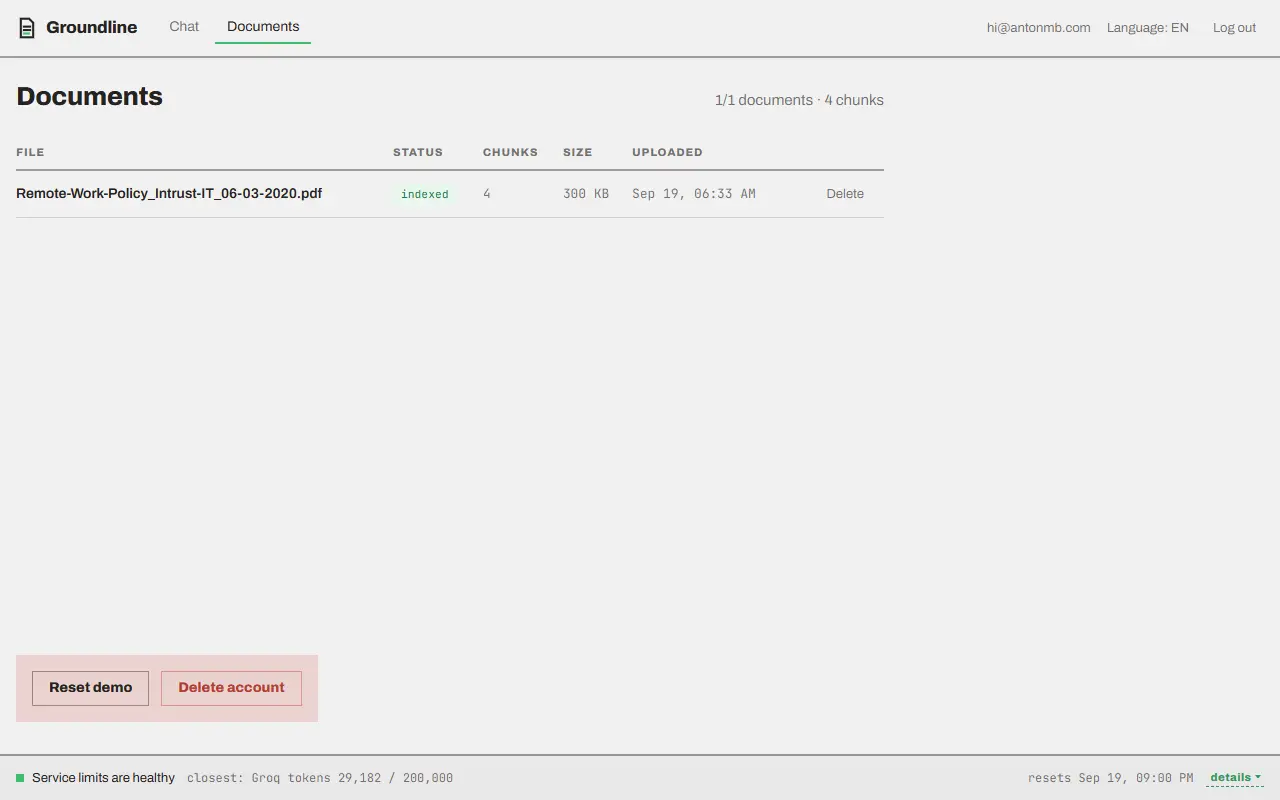
Você envia documentos em PDF, TXT ou Markdown e faz perguntas. Na saída recebe uma resposta clara com referências precisas à fonte: o arquivo, o trecho exato e a página. O modelo está estritamente proibido de inventar, ele trabalha apenas com o que foi realmente encontrado no texto.
Por dentro: sete passos de uma resposta
Quando chega uma pergunta, o sistema não corre direto para o modelo, ele percorre honestamente toda a cadeia.
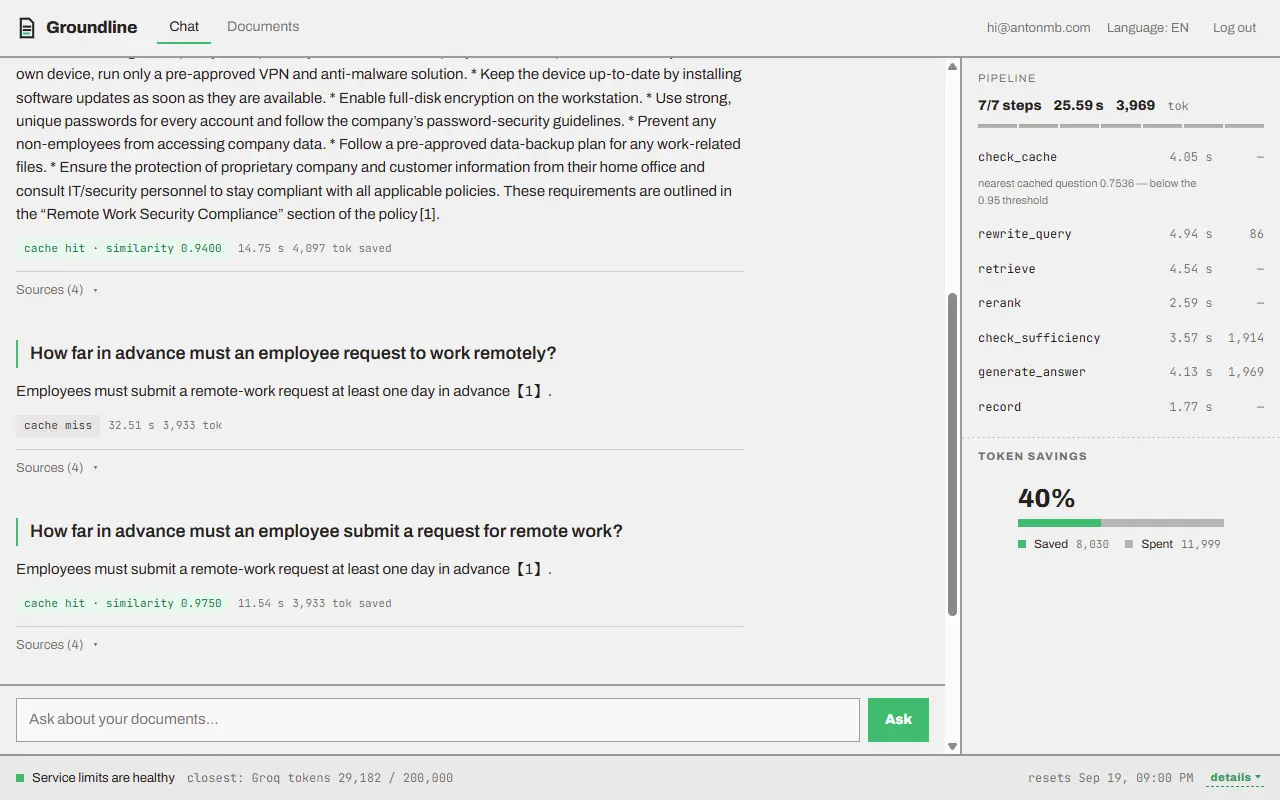
- Cache semântico. Verificamos se já respondemos algo parecido. Se sim, devolvemos a resposta na hora sem gastar um único token.
- Reformulação. Se o cache errou, o modelo limpa a pergunta e expande as abreviações em uma consulta de busca decente.
- Busca híbrida. Rodamos em paralelo a busca vetorial por significado e a busca de texto completo por palavras exatas. A primeira capta sinônimos muito bem, a segunda não perde códigos, termos e referências específicas.
- Reordenação. Um modelo dedicado avalia os trechos recuperados e os reordena não pela semelhança formal, mas por quanto o fragmento realmente responde à pergunta.
- Autoverificação. O modelo avalia se o contexto é suficiente. Se não for, outra busca é disparada indicando exatamente o que falta, com no máximo duas tentativas adicionais.
- Geração. A resposta é transmitida ao usuário palavra por palavra.
- Gravação e cache. A resposta vai para o histórico e para o cache, para futuras perguntas parecidas.
O cache pelo qual tudo começou
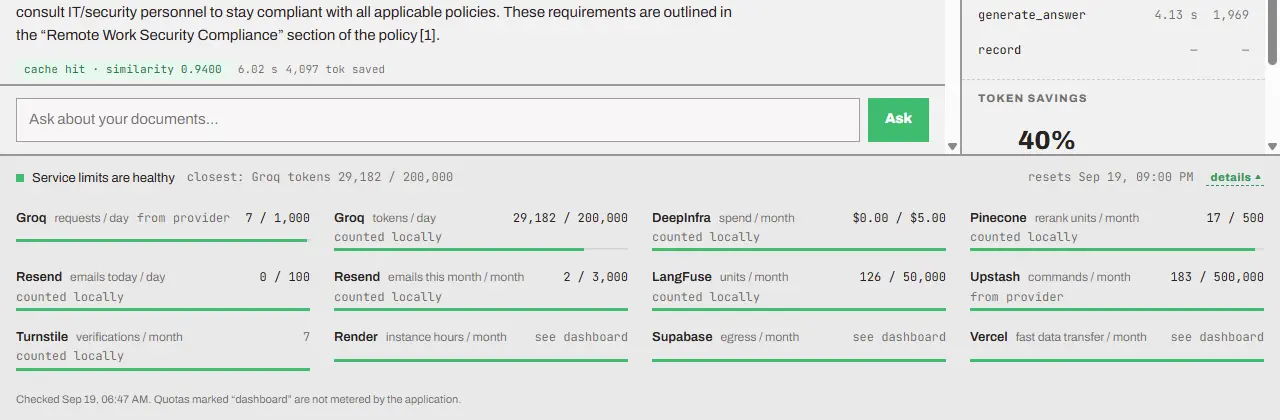
O limiar de similaridade do cache não saiu do nada. Cada consulta registra a proximidade com a pergunta armazenada mais próxima, mesmo quando o cache não dispara. Com essas métricas ajustei o limiar para capturar reformulações reais sem jogar perguntas diferentes no mesmo balde.
No meu conjunto de teste com perguntas repetidas o cache cobre de 60 a 65 por cento das consultas. Em cenários de usuário realmente únicos esse número será menor, claro, mas o ganho econômico continua perceptível.
E a economia aparece enquanto o serviço trabalha:
- qual passo do pipeline está rodando agora e quantos milissegundos ou tokens ele consumiu;
- um gráfico ao vivo do gasto com o modelo contra o dinheiro economizado pelo cache.
Contra o que foi preciso lutar
- Disputa pelo processador. Os modelos locais de embeddings e de reordenação disputavam a CPU com a indexação em segundo plano dos arquivos novos. No pico, uma consulta comum levava 83 segundos em vez de algumas centenas de milissegundos. Resolvi com serialização rígida: a indexação de fundo e o processamento de perguntas agora esperam sua vez de acessar os modelos.
- Vazamento de conexões com o banco de dados. Se o usuário fechava a aba bem no meio da geração, a conexão ficava presa no pool. Numa hospedagem gratuita com limite microscópico de conexões isso derrubava o serviço rapidamente. Corrigi protegendo a gravação final no banco contra o cancelamento.
Pilha técnica
- Backend: FastAPI, LangGraph, Python.
- Banco de dados: Postgres com a extensão pgvector para busca vetorial, SQLAlchemy e Alembic para migrações.
- Segurança: o isolamento de dados entre usuários não depende só do código, mas de Row-Level Security dentro do próprio banco. Um filtro esquecido numa consulta não vaza arquivos alheios.
- Modelos e monitoramento: Groq para respostas rápidas, LangFuse para rastrear cada passo e a biblioteca ragas para avaliar qualidade, incluindo precisão, cobertura do contexto e ausência de alucinações.
Como essa cadeia se parece
Esses mesmos sete passos ficam mais claros vendo uma vez do que lendo. Um esquema interativo leva uma consulta por toda a cadeia e mostra o que muda em cada etapa:
Como um modelo responde a partir dos seus documentosOnde experimentar
O acesso é por código de uso único enviado por e-mail, sem senhas. Envie o seu próprio documento ou use o corpus de teste, faça uma pergunta e depois reformule. A diferença de velocidade e de custo aparece na hora.
groundline.antonmb.com Código-fonte no GitHubVou gostar de receber comentários construtivos e discussão, principalmente de quem já colocou serviços parecidos em produção e sabe onde mais essa arquitetura costuma esconder seus rastelos.
Contato e colaboração















































