Groundline:一个自己计算省下多少钱的 RAG 服务
用 FastAPI 和 LangGraph 做的个人项目:混合检索、重排序、自检,以及覆盖 60 到 65 个百分点重复提问的语义缓存。省下的钱直接显示在界面上。
最近几天我做了一个名叫 Groundline 的个人项目,想聊聊为什么把它做成这个样子,以及它解决了哪些问题。
为什么还要再做一个 RAG
如今搭一个基础的文档检索并不难,教程成千上万。但大多数练手和演示项目停在「太好了,它总算能回答」这一步。真实业务关心的是另一个问题:运行它要花多少钱。
每一次调用语言模型都在花真金白银和等待时间。如果用户反复用不同措辞问同一件事,而系统每次都重新跑完整的向量检索并从零生成答案,预算就消耗在重复已经做过的工作上。
所以我决定做一个服务,它不只是解决文档问答,还要把省下的钱用诚实的数字直接摆出来。
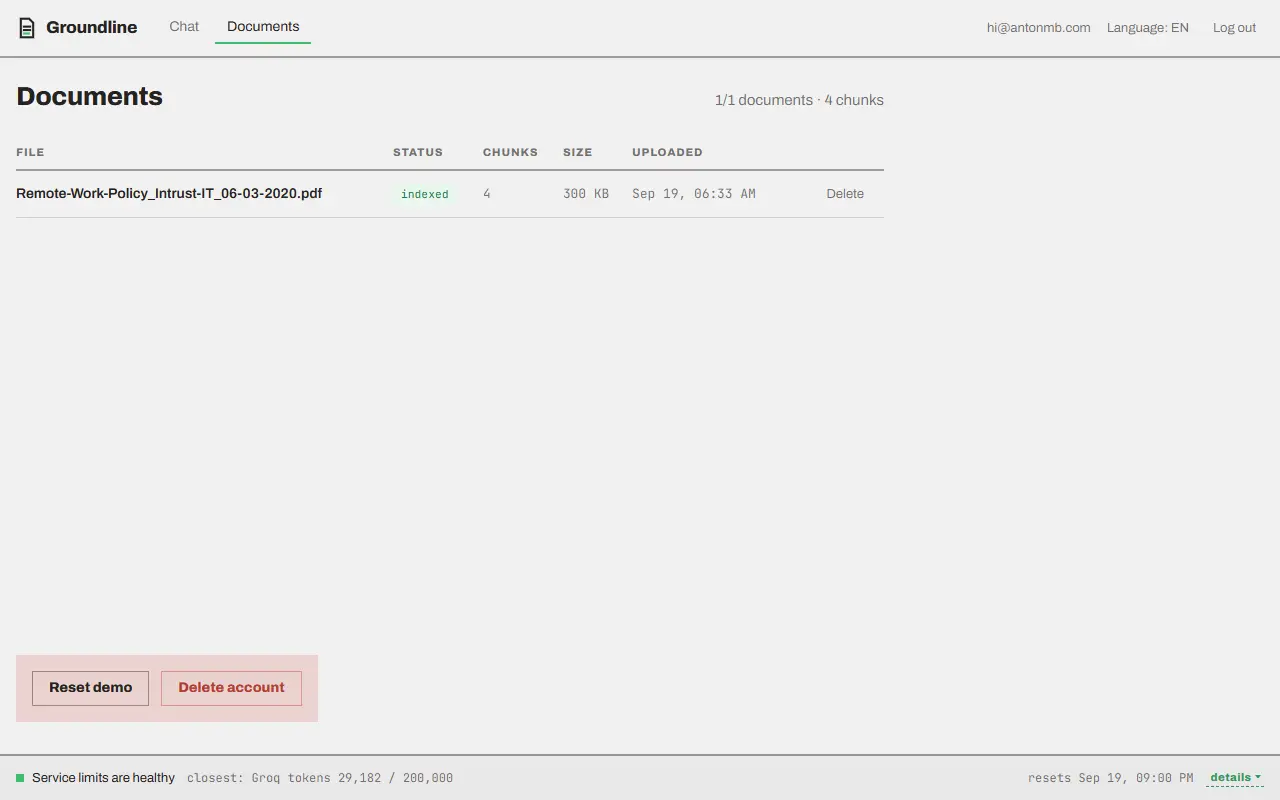
用户看到的样子
上传 PDF、TXT 或 Markdown 文档然后提问。得到的是一个清晰的答案,并附带精确的来源指引:文件、具体片段和页码。模型被严格禁止凭空发挥,只能使用文本中真正检索到的内容。
揭开盖子:一个答案的七个步骤
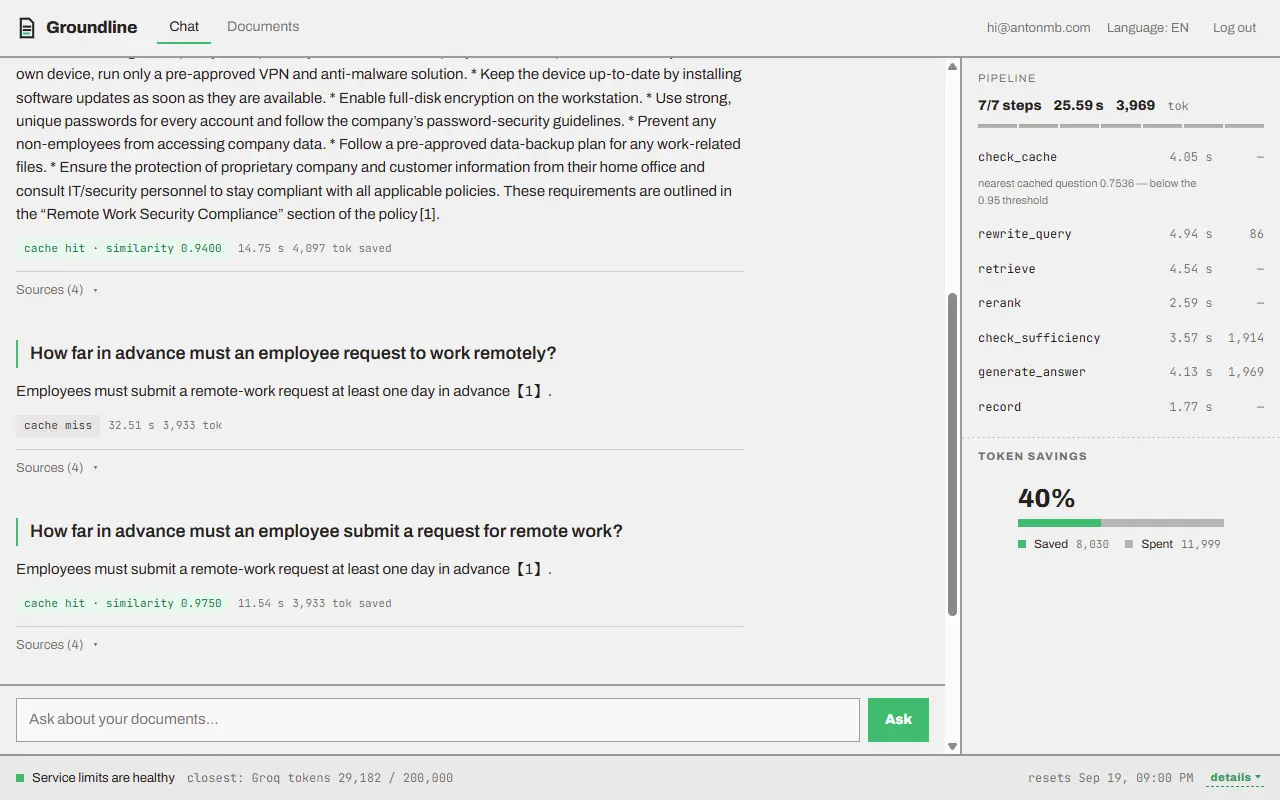
问题到来时,系统不会直接冲向模型,而是老老实实走完整条链路。
- 语义缓存。先检查是否已经回答过类似的问题。如果有,就立刻返回答案,一个 token 也不花。
- 改写。缓存没命中时,模型清理问题中的冗余,把缩写展开成规整的检索语句。
- 混合检索。按语义的向量检索和按精确词的全文检索并行启动。前者很擅长捕捉同义词,后者不会丢掉料号、术语和编码。
- 重排序。一个专门的模型给检索到的片段打分,并不按形式上的相似度排列,而是按片段究竟在多大程度上回答了问题。
- 自检。模型判断上下文是否足够。如果不够,就带着「究竟缺什么」的说明再检索一次,最多两次额外尝试。
- 生成。答案逐词流式传给用户。
- 保存与缓存。答案写入历史,并送进缓存,供将来类似的问题使用。
整件事的起点:缓存
缓存的相似度阈值不是拍脑袋定的。每一次请求都会记录它与最接近的已存问题之间的相似度,即使缓存没有命中也照样记录。我依据这些指标把阈值调到既能抓住真正的换一种说法,又不会把不同的问题混成一堆。
在我这份包含重复问题的测试数据上,缓存覆盖了 60 到 65 个百分点的请求。在真正独一无二的用户场景里这个数字当然会更低,但经济收益依然实实在在。
而且省下的部分在运行过程中就能看到:
- 当前正在执行流水线的哪一步,它消耗了多少毫秒或多少 token;
- 一张实时图表,把模型花费和缓存省下的钱放在一起对比。
踩过的坑
- 处理器争抢。负责嵌入和重排序的本地模型与新文件的后台索引在抢 CPU。峰值时,一个普通请求不是几百毫秒,而是挂了 83 秒。我用严格的串行化解决了它:后台索引和问题处理被彻底分开,各自排队访问模型。
- 数据库连接泄漏。如果用户正好在生成答案时关掉标签页,连接就会卡死在连接池里。在连接数上限小得可怜的免费主机上,这很快会让服务瘫痪。修复办法是让写入数据库的最后一步不受取消影响。
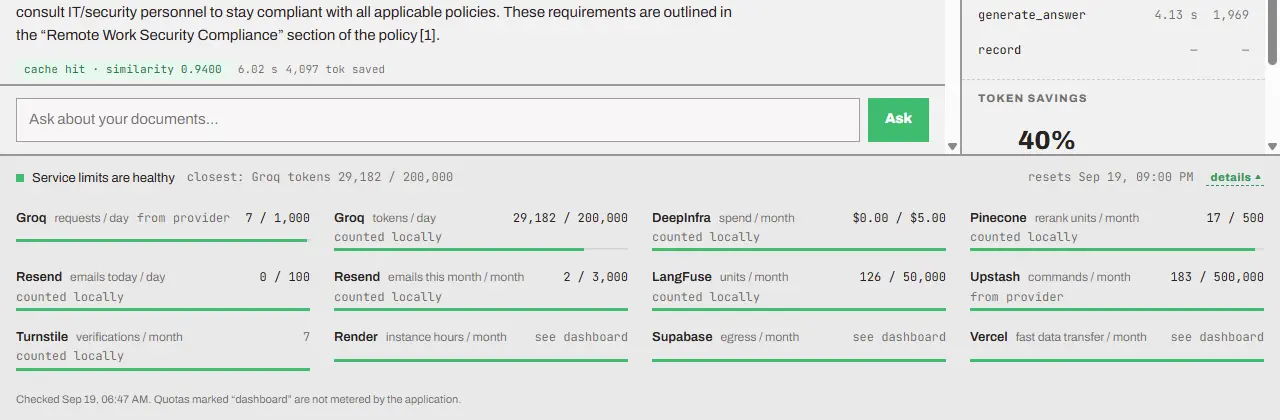
技术栈
- 后端:FastAPI、LangGraph、Python。
- 数据库:带 pgvector 扩展的 Postgres 负责向量检索,SQLAlchemy 和 Alembic 负责迁移。
- 安全:用户之间的数据隔离不只依赖代码,还依赖数据库里的行级安全策略。查询里漏写一个过滤条件也不会泄露别人的文件。
- 模型与监控:Groq 提供快速回答,LangFuse 追踪每一步,ragas 库评估质量,包括准确率、上下文召回和有无幻觉。
这样一条链路长什么样
同样的七个步骤,看一遍比读一遍更容易记住。一张可交互的图会把一次查询带过整条链路,并显示每个阶段发生了什么变化:
模型如何依据你的文档作答在哪里试用
登录方式是邮箱收到的一次性验证码,没有密码。上传你自己的文档,或者直接用测试语料,先提一个问题,再换一种说法问一遍。速度和成本的差别立刻就能看到。
groundline.antonmb.com GitHub 上的源码欢迎建设性的反馈和讨论,尤其欢迎已经把类似服务送上生产环境、知道这类架构还会在哪里埋雷的人来聊聊。
联系方式与合作















































