Groundline: un servicio RAG que calcula cuánto dinero ahorra
Un proyecto personal con FastAPI y LangGraph: búsqueda híbrida, reordenamiento, autoverificación y una caché semántica que cubre del 60 al 65 por ciento de las preguntas repetidas. El ahorro se ve en la propia interfaz.
Durante los últimos días armé un proyecto personal llamado Groundline y quiero contar por qué lo hice así y qué problemas resuelve.
Por qué otro RAG
Hoy montar una búsqueda básica sobre documentos ya no es un problema, hay miles de tutoriales. Pero la mayoría de los proyectos de aprendizaje y de demostración se detienen en la etapa de «genial, responde algo». En un negocio real la pregunta principal es otra: cuánto cuesta operarlo.
Cada llamada a un modelo de lenguaje cuesta dinero real y segundos de espera. Si los usuarios preguntan lo mismo con palabras distintas y el sistema vuelve a ejecutar la búsqueda vectorial completa y genera la respuesta desde cero cada vez, el presupuesto se gasta en repetir trabajo ya hecho.
Decidí construir un servicio que no solo resuelve la búsqueda sobre documentos, sino que además muestra el ahorro de forma visible, con cifras honestas.
Cómo funciona para el usuario
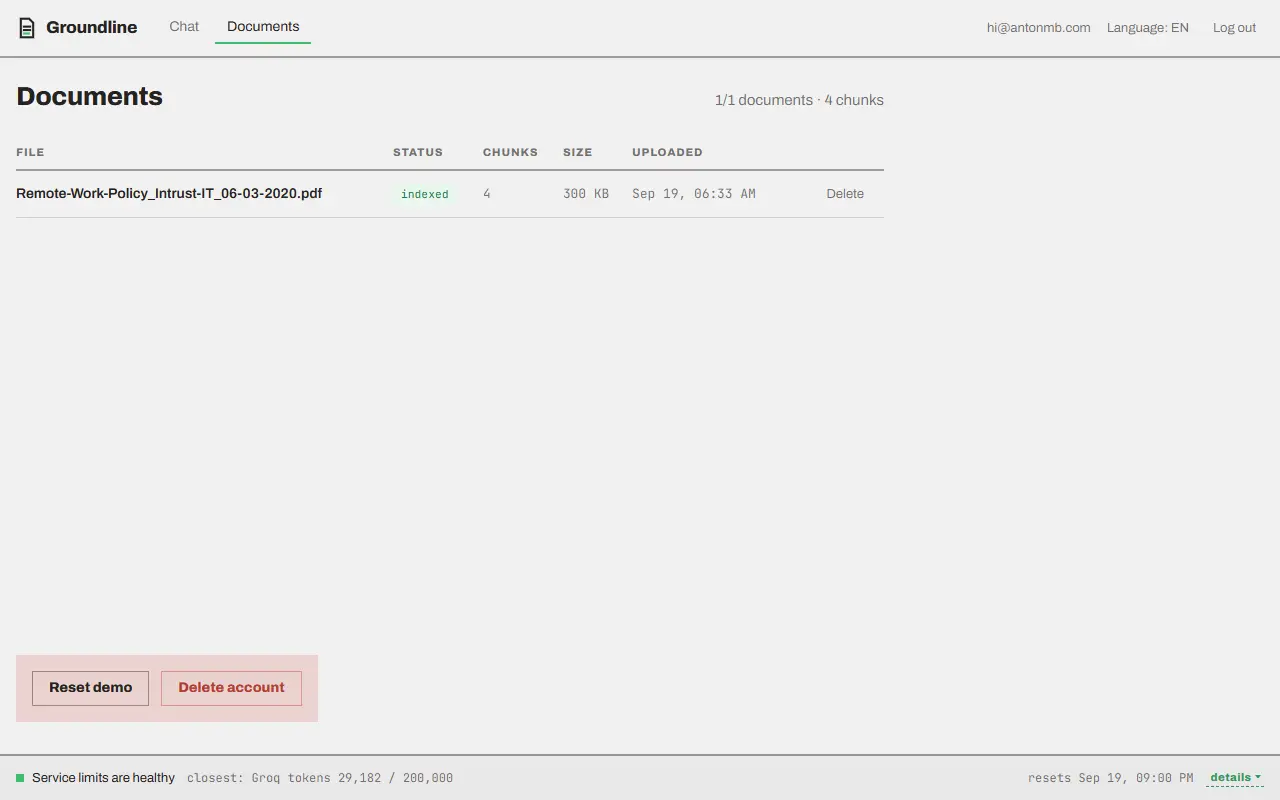
Sube documentos en PDF, TXT o Markdown y hace preguntas. A la salida recibe una respuesta clara con referencias precisas a la fuente: el archivo, el fragmento concreto y la página. Al modelo le está estrictamente prohibido inventar, trabaja solo con lo que realmente se encontró en el texto.
Bajo el capó: siete pasos de una respuesta
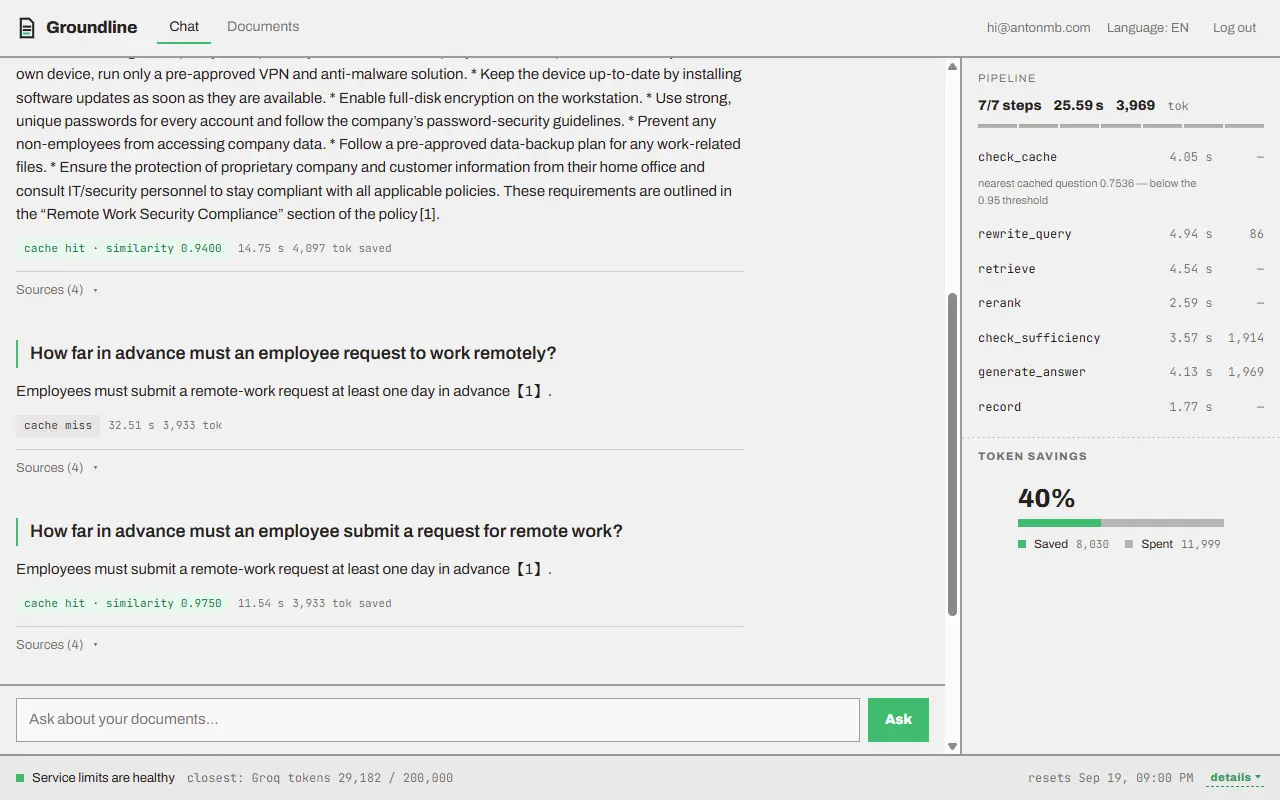
Cuando llega una pregunta, el sistema no corre directo al modelo, sino que recorre honestamente toda la cadena.
- Caché semántica. Comprobamos si ya respondimos algo parecido. Si es así, devolvemos la respuesta al instante sin gastar ni un token.
- Reformulación. Si la caché falló, el modelo limpia la pregunta y expande las abreviaturas en una consulta de búsqueda decente.
- Búsqueda híbrida. Lanzamos en paralelo la búsqueda vectorial por significado y la de texto completo por palabras exactas. La primera capta muy bien los sinónimos, la segunda no pierde referencias, términos ni códigos específicos.
- Reordenamiento. Un modelo dedicado evalúa los fragmentos recuperados y los reordena no por parecido formal, sino por cuánto responden realmente a la pregunta.
- Autoverificación. El modelo juzga si el contexto es suficiente. Si no lo es, se lanza otra búsqueda precisando qué falta exactamente, con un máximo de dos intentos adicionales.
- Generación. La respuesta se transmite al usuario palabra por palabra.
- Guardado y caché. La respuesta va al historial y a la caché para futuras preguntas parecidas.
La caché por la que empezó todo
El umbral de similitud de la caché no salió del aire. Cada consulta registra su cercanía con la pregunta guardada más próxima, incluso cuando la caché no se activa. Con esas métricas ajusté el umbral para capturar reformulaciones reales sin mezclar preguntas distintas en un mismo saco.
En mi conjunto de prueba con preguntas repetidas la caché cubre entre el 60 y el 65 por ciento de las consultas. En escenarios de usuario realmente únicos la cifra será menor, por supuesto, pero el beneficio económico sigue siendo tangible.
Y el ahorro se ve mientras el servicio trabaja:
- qué paso del pipeline se está ejecutando ahora y cuántos milisegundos o tokens consumió;
- un gráfico en vivo del gasto en el modelo frente al dinero que ahorró la caché.
Contra qué hubo que pelear
- Competencia por el procesador. Los modelos locales de embeddings y de reordenamiento peleaban por la CPU con la indexación en segundo plano de los archivos nuevos. En el pico, una consulta normal tardaba 83 segundos en lugar de unos cientos de milisegundos. Lo resolví con una serialización estricta: la indexación de fondo y el procesamiento de preguntas ahora esperan su turno para acceder a los modelos.
- Fuga de conexiones a la base de datos. Si el usuario cerraba la pestaña justo durante la generación, la conexión quedaba pegada en el pool. En un hosting gratuito con un límite de conexiones microscópico eso tumbaba el servicio enseguida. Lo arreglé protegiendo de la cancelación la escritura final en la base de datos.
Pila técnica
- Backend: FastAPI, LangGraph, Python.
- Base de datos: Postgres con la extensión pgvector para la búsqueda vectorial, SQLAlchemy y Alembic para las migraciones.
- Seguridad: el aislamiento de datos entre usuarios no depende solo del código, sino de Row-Level Security dentro de la propia base de datos. Un filtro olvidado en una consulta no filtrará archivos ajenos.
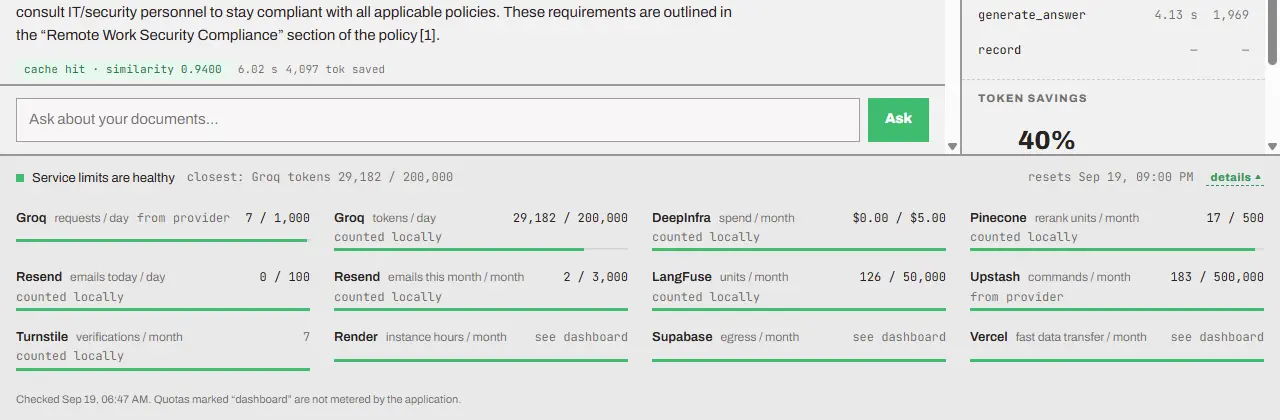
- Modelos y monitoreo: Groq para respuestas rápidas, LangFuse para trazar cada paso y la librería ragas para evaluar la calidad, incluidas la precisión, la cobertura del contexto y la ausencia de alucinaciones.
Cómo se ve esa cadena
Esos mismos siete pasos se entienden mejor viéndolos una vez que leyéndolos. Un esquema interactivo lleva una consulta por toda la cadena y muestra qué cambia en cada etapa:
Cómo responde un modelo a partir de tus documentosDónde probarlo
El acceso es con un código de un solo uso enviado por correo, sin contraseñas. Suba su propio documento o use el corpus de prueba, haga una pregunta y luego reformúlela. Verá la diferencia de velocidad y de coste al instante.
groundline.antonmb.com Código fuente en GitHubAgradeceré comentarios constructivos y discusión, sobre todo de quienes ya llevaron servicios parecidos a producción y saben dónde más suele esconder sus rastrillos esta arquitectura.
Contacto y colaboración















































