Groundline : un service RAG qui calcule lui-même l'argent qu'il économise
Un projet personnel en FastAPI et LangGraph : recherche hybride, réordonnancement, auto-vérification et un cache sémantique qui couvre de 60 à 65 pour cent des questions répétées. L'économie se voit dans l'interface.
Ces derniers jours j'ai monté un projet personnel appelé Groundline et je veux raconter pourquoi je l'ai fait ainsi et quels problèmes il résout.
Pourquoi encore un RAG
Construire une recherche documentaire de base n'est plus un problème aujourd'hui, les tutoriels se comptent par milliers. Mais la plupart des projets pédagogiques et des démonstrations s'arrêtent au stade «super, ça répond à peu près». Dans une vraie entreprise la question principale est autre : combien coûte l'exploitation.
Chaque appel à un modèle de langage coûte de l'argent réel et des secondes d'attente. Si les utilisateurs posent la même question avec des mots différents et que le système relance à chaque fois la recherche vectorielle complète et génère la réponse depuis zéro, le budget part dans du travail déjà fait.
J'ai donc décidé de construire un service qui ne se contente pas de répondre sur des documents, mais qui montre l'économie de façon visible, en chiffres honnêtes.
Comment cela fonctionne pour l'utilisateur
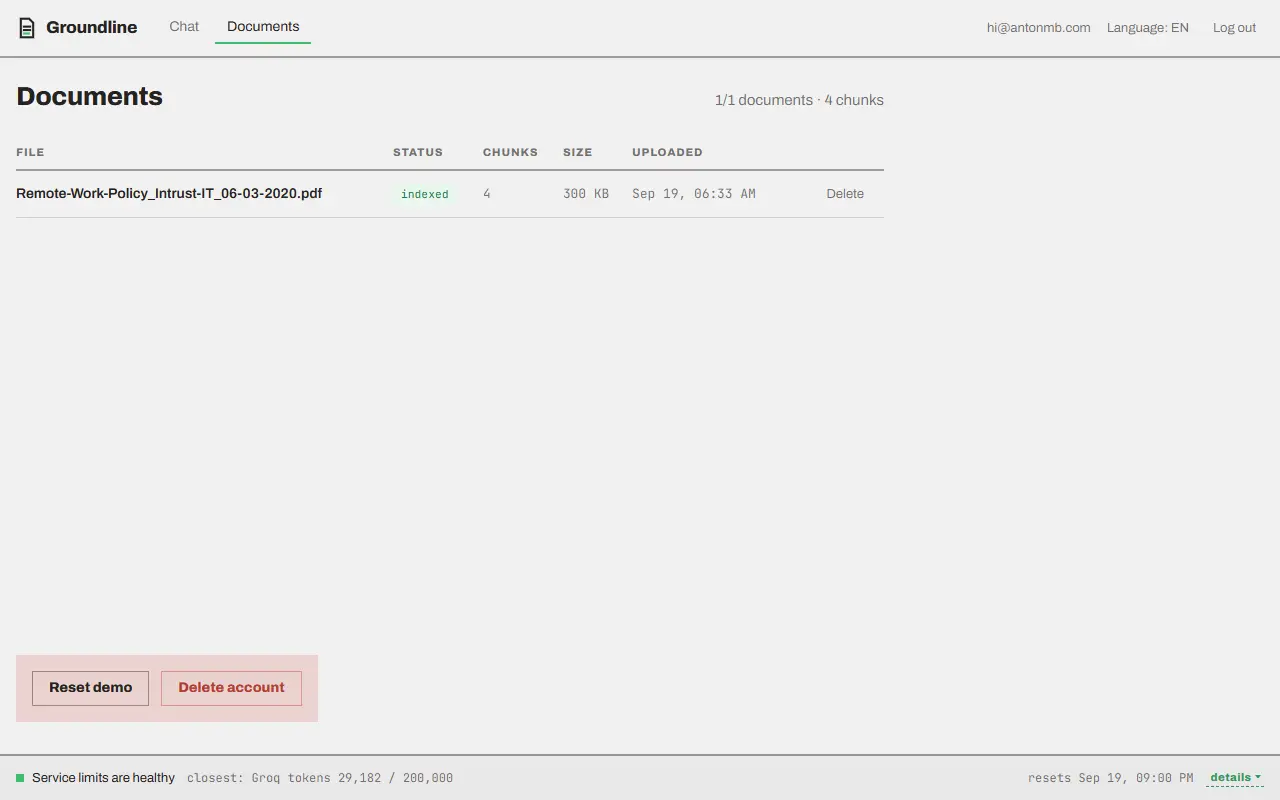
Vous chargez des documents en PDF, TXT ou Markdown et vous posez des questions. En sortie vous obtenez une réponse nette avec des références précises à la source : le fichier, le fragment exact et la page. Il est strictement interdit au modèle d'inventer, il travaille uniquement avec ce qui a réellement été trouvé dans le texte.
Sous le capot : sept étapes pour une réponse
Quand une question arrive, le système ne court pas directement au modèle, il parcourt honnêtement toute la chaîne.
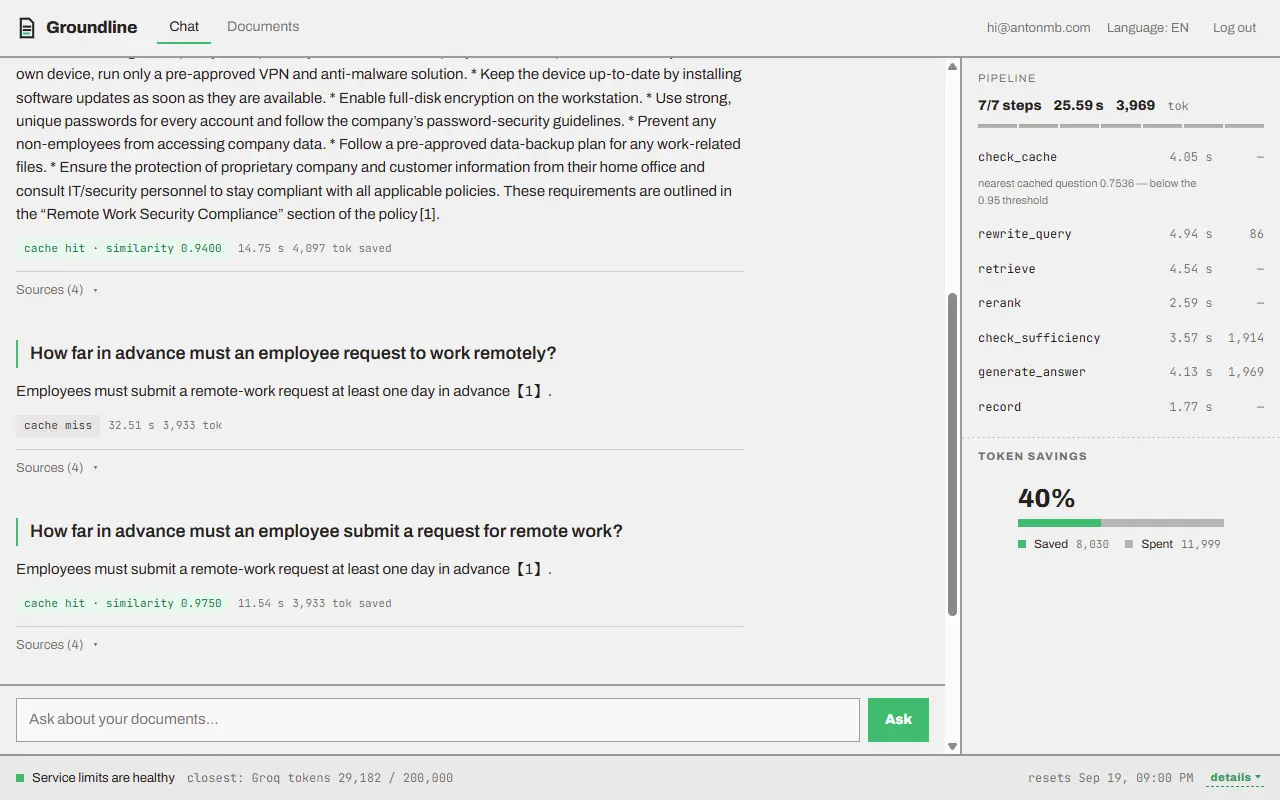
- Cache sémantique. On vérifie si l'on a déjà répondu à quelque chose de proche. Si oui, la réponse revient instantanément sans dépenser un seul jeton.
- Reformulation. Si le cache a raté, le modèle nettoie la question et développe les abréviations en une vraie requête de recherche.
- Recherche hybride. La recherche vectorielle par le sens et la recherche plein texte par mots exacts tournent en parallèle. La première attrape très bien les synonymes, la seconde ne perd ni les références, ni les termes, ni les codes spécifiques.
- Réordonnancement. Un modèle dédié note les passages trouvés et les retrie non par similarité formelle, mais selon la mesure dans laquelle le fragment répond vraiment à la question.
- Auto-vérification. Le modèle juge si le contexte suffit. Sinon, une nouvelle recherche est lancée en précisant ce qui manque exactement, avec deux tentatives supplémentaires au maximum.
- Génération. La réponse est diffusée à l'utilisateur mot après mot.
- Enregistrement et mise en cache. La réponse rejoint l'historique et le cache pour les futures questions proches.
Le cache pour lequel tout a commencé
Le seuil de similarité du cache n'a pas été pris au hasard. Chaque requête enregistre sa proximité avec la question stockée la plus proche, même quand le cache n'a pas fonctionné. Ces mesures m'ont permis de régler le seuil pour attraper les vraies reformulations sans mélanger des questions différentes.
Sur mon jeu de test avec des questions répétées, le cache couvre de 60 à 65 pour cent des requêtes. Sur des scénarios utilisateurs vraiment uniques ce chiffre sera bien sûr plus bas, mais le gain économique reste sensible.
Et l'économie se voit pendant que le service travaille :
- quelle étape du pipeline tourne en ce moment et combien de millisecondes ou de jetons elle a consommés ;
- un graphique en direct des dépenses en modèle face à l'argent économisé par le cache.
Ce contre quoi il a fallu se battre
- Conflit pour le processeur. Les modèles locaux d'embeddings et de réordonnancement se disputaient le processeur avec l'indexation en arrière-plan des nouveaux fichiers. Au pic, une requête ordinaire restait 83 secondes en attente au lieu de quelques centaines de millisecondes. Réglé par une sérialisation stricte : l'indexation de fond et le traitement des questions attendent maintenant chacune leur tour l'accès aux modèles.
- Fuite de connexions à la base de données. Si l'utilisateur fermait l'onglet en pleine génération, la connexion restait coincée dans le pool. Sur un hébergement gratuit à la limite de connexions minuscule, cela faisait tomber le service très vite. Corrigé en protégeant de l'annulation l'écriture finale en base.
Pile technique
- Backend : FastAPI, LangGraph, Python.
- Base de données : Postgres avec l'extension pgvector pour la recherche vectorielle, SQLAlchemy et Alembic pour les migrations.
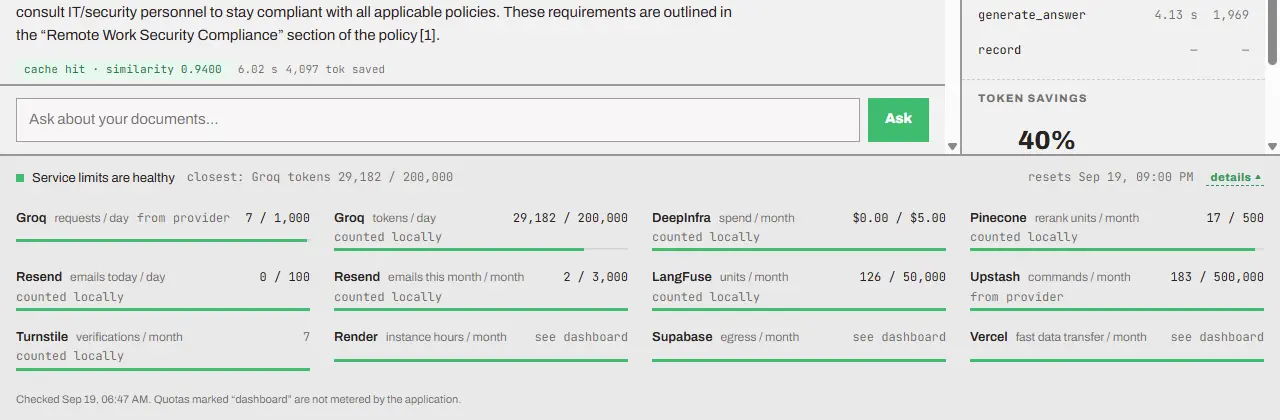
- Sécurité : l'isolation des données entre utilisateurs ne repose pas seulement sur le code mais sur la Row-Level Security dans la base elle-même. Un filtre oublié dans une requête ne laissera pas fuiter les fichiers d'autrui.
- Modèles et supervision : Groq pour les réponses rapides, LangFuse pour tracer chaque étape, la bibliothèque ragas pour évaluer la qualité, y compris la précision, la couverture du contexte et l'absence d'hallucinations.
À quoi ressemble une telle chaîne
Ces sept étapes se comprennent mieux une fois vues que lues. Un schéma interactif fait passer une requête dans toute la chaîne et montre ce qui change à chaque étape :
Comment un modèle répond à partir de vos documentsOù l'essayer
La connexion se fait par code à usage unique envoyé par courriel, sans mot de passe. Chargez votre propre document ou prenez le corpus de test, posez une question, puis reformulez-la. La différence de vitesse et de coût se voit tout de suite.
groundline.antonmb.com Code source sur GitHubLes retours constructifs et la discussion sont les bienvenus, en particulier de la part de ceux qui ont déjà mis des services semblables en production et savent où cette architecture aime encore cacher ses pièges.
Contact et collaboration















































