Groundline: RAG-сервіс, який сам рахує, скільки грошей заощадив
Пет-проєкт на FastAPI і LangGraph: гібридний пошук, переранжування, самоперевірка і семантичний кеш, який закриває від 60 до 65 відсотків повторних питань. Економію видно просто в інтерфейсі.
За останні кілька днів я зібрав пет-проєкт під назвою Groundline і хочу поділитися, чому зробив його саме таким і які задачі він вирішує.
Навіщо ще один RAG
Зробити базовий пошук по документах зараз не проблема, адже туторіалів тисячі. Але більшість навчальних і демонстраційних проєктів зупиняється на стадії «ура, воно якось відповідає». У реальному бізнесі головне питання інше: скільки коштує це експлуатувати.
Кожен запит до мовних моделей коштує живих грошей і секунд очікування. Якщо користувачі часто питають те саме різними словами, а система щоразу заново проганяє повний векторний пошук і генерує відповідь з нуля, бюджет витрачається на повторну роботу.
Я вирішив побудувати сервіс, який не просто закриває задачі пошуку по документах, а й показує економію наочно, у чесних цифрах.
Як це працює для користувача
Завантажуєте документи у форматах PDF, TXT або Markdown і ставите питання. На виході отримуєте чітку відповідь із точними посиланнями на джерело: файл, конкретний фрагмент і сторінку. Моделі суворо заборонено фантазувати, вона працює лише з тим, що справді знайдено в тексті.
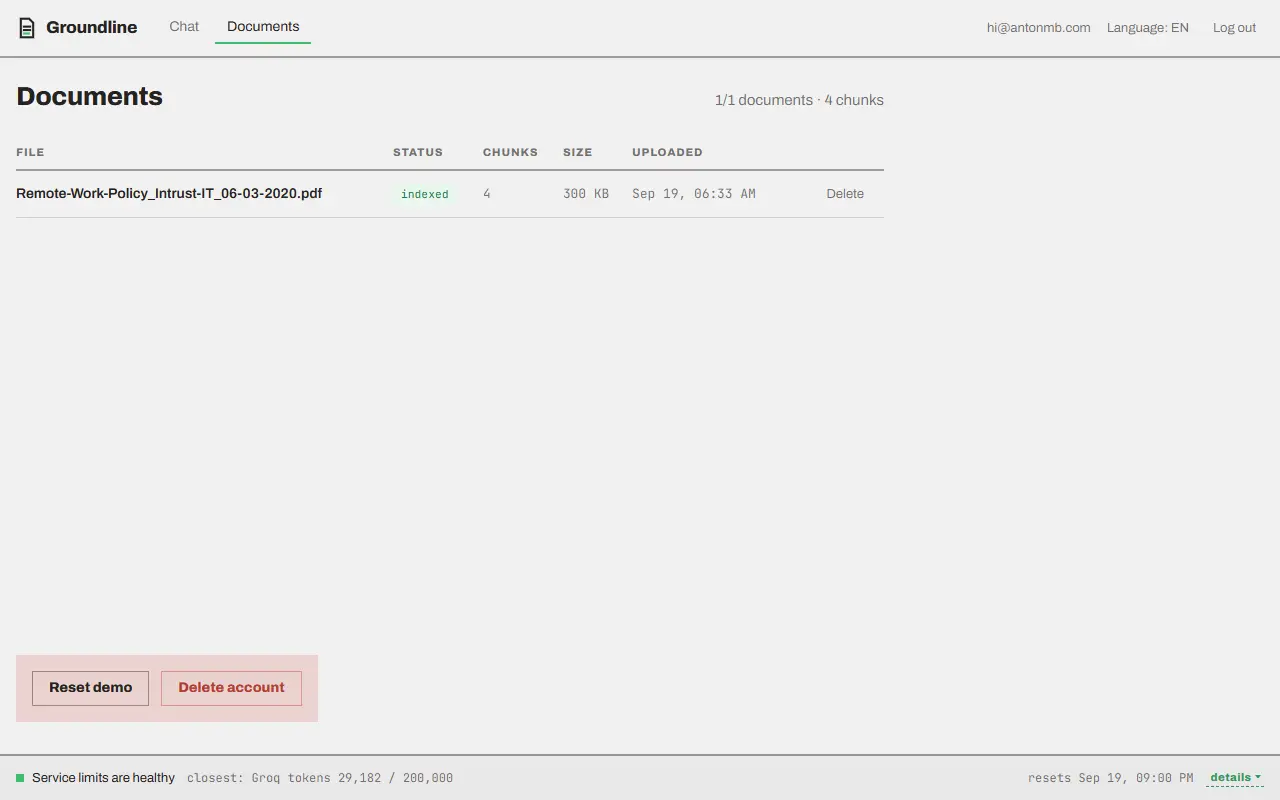
Під капотом: сім кроків однієї відповіді
Коли надходить питання, система не біжить одразу до моделі, а чесно проганяє весь ланцюжок.
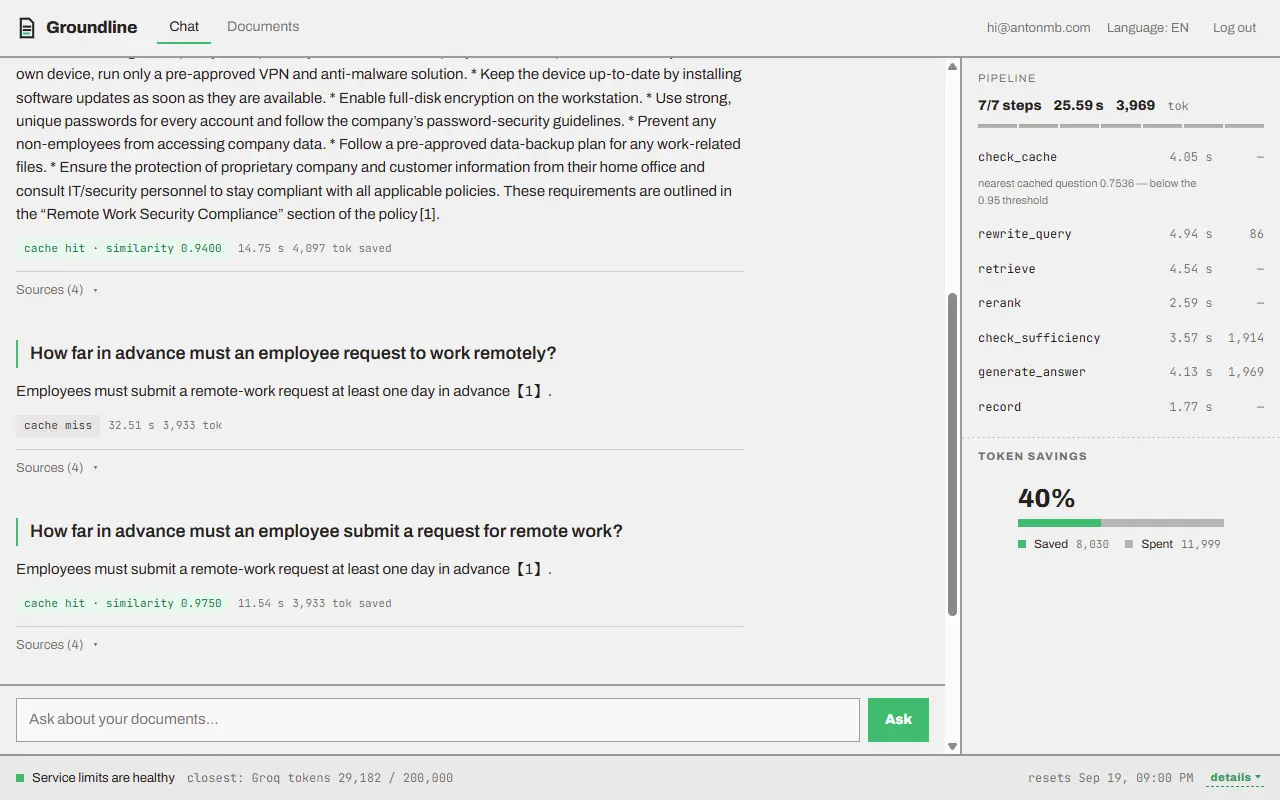
- Семантичний кеш. Перевіряємо, чи не відповідали ми вже на щось подібне. Якщо так, віддаємо відповідь миттєво, не витративши жодного токена.
- Переформулювання. Якщо кеш схибив, модель чистить питання від сміття і розгортає скорочення в нормальний пошуковий запит.
- Гібридний пошук. Запускаємо паралельно векторний пошук за змістом і повнотекстовий за точними словами. Перший чудово ловить синоніми, другий не губить специфічні артикули, терміни й коди.
- Переранжування. Спеціальна модель оцінює знайдені шматки і пересортовує їх не просто за формальною схожістю, а за тим, наскільки фрагмент справді відповідає на питання.
- Самоперевірка. Модель оцінює, чи достатньо контексту. Якщо ні, запускається повторний пошук із уточненням, чого саме бракує, максимум дві додаткові спроби.
- Генерація. Відповідь стримиться користувачеві слово за словом.
- Збереження і кешування. Відповідь записується в історію і вирушає в кеш для майбутніх схожих питань.
Кеш, заради якого все затівалося
Поріг схожості для кеша я не брав зі стелі. Кожен запит логує ступінь подібності до найближчого збереженого питання, навіть якщо кеш не спрацював. На основі цих метрик я підібрав поріг так, щоб забирати справжні перефразування, але не звалювати різні питання в одну купу.
На моєму тестовому наборі даних із повторюваними питаннями кеш успішно закриває від 60 до 65 відсотків запитів. Звісно, на унікальних користувацьких сценаріях ця цифра буде нижчою, але економічна вигода все одно відчутна.
До того ж економія видно прямо в процесі роботи:
- який крок пайплайну йде просто зараз і скільки мілісекунд чи токенів він з'їв;
- живий графік витрат на модель проти заощаджених кешем грошей.
З чим довелося повоювати
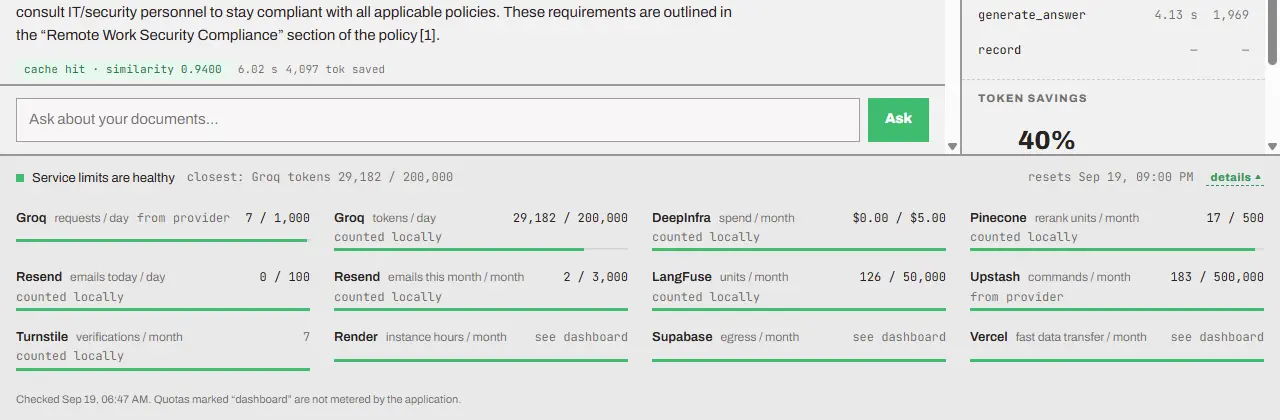
- Конфлікт за процесор. Локальні моделі для ембедингів і реранкінгу разом із фоновою індексацією нових файлів активно ділили процесор. У піку один звичайний запит замість сотень мілісекунд висів 83 секунди. Розв'язав жорсткою серіалізацією: фонова індексація й обробка питань тепер суворо розведені й чекають своєї черги до моделей.
- Витік з'єднань із базою даних. Якщо користувач закривав вкладку просто під час генерації відповіді, коннект до бази залипав у пулі. На безкоштовному хостингу з мікроскопічним лімітом з'єднань це швидко призводило до падіння сервісу. Полагодив через захист фінальної операції запису в базу даних від скасування.
Технічний стек
- Backend: FastAPI, LangGraph, Python.
- База даних: Postgres із розширенням pgvector для векторного пошуку, SQLAlchemy та Alembic для міграцій.
- Безпека: ізоляція даних між користувачами зав'язана не лише на код, а й на Row-Level Security просто в базі даних. Забутий фільтр у запиті не зіллє чужі файли.
- Моделі й моніторинг: Groq для швидких відповідей, LangFuse для трасування кожного кроку, бібліотека ragas для оцінки якості, включно з точністю, повнотою контексту й відсутністю галюцинацій.
Як виглядає такий ланцюжок
Ті самі сім кроків зручніше один раз побачити, ніж прочитати. Інтерактивна схема проводить запит усім ланцюжком і показує, що змінюється на кожному етапі:
Як модель відповідає за вашими документамиДе помацати
Вхід за одноразовим кодом на пошту, без паролів. Завантажте свій документ або візьміть тестовий корпус, поставте питання, а потім перефразуйте його. Різницю у швидкості й вартості побачите одразу.
groundline.antonmb.com Вихідний код на GitHubБуду радий конструктивному фідбеку й дискусії, особливо від тих, хто вже запускав подібні сервіси в продакшн і знає, де ще в такій архітектурі люблять ховатися граблі.
Контакти й співпраця















































