Como construí sem querer um sistema de orquestração de LLM no navegador
Um olhar arquitetural sobre como o Litseller usou a API do GPT, React, prompts e orquestração no navegador para gerar conteúdo estruturado de um catálogo de livros.
Há dois anos, construí o Litseller.
Naquele momento eu não pensava em orquestração de LLM nem na arquitetura desse tipo de sistema. Estava só resolvendo um problema específico: como gerar rapidamente conteúdo estruturado para um catálogo de livros.
Olhando para trás agora, entendo que aquilo era, em essência, um sistema completo de orquestração de LLM. Só que implementado não no backend, e sim direto no navegador.
O que aquilo era de fato
É importante enquadrar isso corretamente.
O Litseller não era um serviço de LLM.
Era uma aplicação web clássica com um catálogo, sobre a qual embuti um LLM como ferramenta de geração de dados dentro da área administrativa.
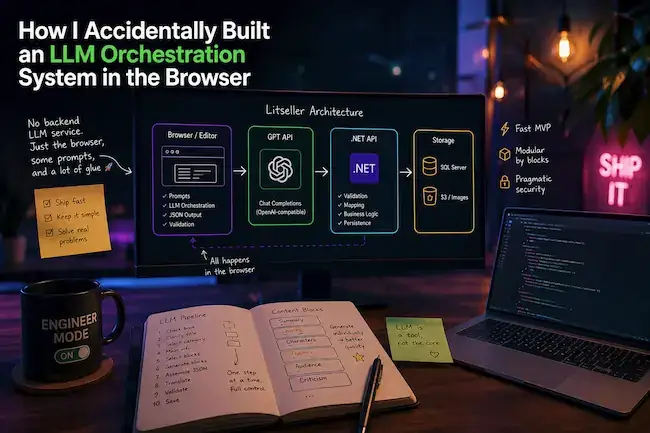
Toda a orquestração acontecia num fluxo simples: interface do editor, API do GPT, JSON, validação, gravação no backend.
- Sem filas.
- Sem workers.
- Sem orquestração no servidor.
- Sem infraestrutura complexa.
Tudo era construído com React, prompts e cadeias de requisições.
Arquitetura
O sistema estava dividido em três camadas.
- Frontend: área administrativa em Next.js, editor e toda a lógica de LLM.
- Backend: API em .NET, validação e persistência.
- Armazenamento: SQL Server e S3.
A lógica de LLM não vivia no backend. As chamadas partiam direto do navegador.
Pipeline de geração
Em vez de uma única requisição grande, montei um pipeline.
- Verificar se o modelo conhece o livro.
- Esclarecer o título, se necessário.
- Escolher uma categoria.
- Gerar as informações principais.
- Escolher os blocos de conteúdo, como resumo, citações, temas e outras seções.
- Gerar cada bloco separadamente.
- Montar o JSON.
- Traduzir o conteúdo para outros idiomas.
- Validar o resultado.
- Salvar os dados finais.
Isso já era orquestração de verdade, só que sem um serviço de orquestração separado.
Por que os blocos funcionaram bem
Gerar o conteúdo por blocos foi uma das decisões mais fortes.
Eu não pedia ao modelo que gerasse a página inteira do livro de uma vez.
- O resumo era gerado à parte.
- Os personagens eram gerados à parte.
- As citações eram geradas à parte.
- Os temas eram gerados à parte.
Isso me deu melhor controle de qualidade, a possibilidade de regerar partes isoladas, um JSON mais estável e menos erros.
Na prática, virou uma camada manual de controle de versão sobre a saída do LLM.
Engenharia de prompts
Os prompts eram simples, mas estruturados.
- Formato JSON estrito.
- Instruções claras.
- Mágica mínima.
O contexto era passado de forma explícita: título, autor, categorias, idioma e blocos anteriores.
- Sem memória de conversa.
- Sem estado complexo.
- Sem tool calling.
A decisão mais polêmica
A chave de API ficava no localStorage.
O motivo era simples: o editor não era uma interface pública, havia pouquíssimos usuários, a prioridade era lançar rápido, e a orquestração no backend teria deixado o sistema bem mais complexo.
Foi uma decisão consciente. Os riscos foram entendidos e aceitos.
Além disso, o acesso era restrito e protegido manualmente via Cloudflare.
Pontos fracos
Olhando com honestidade hoje, os pontos fracos são evidentes.
- Chave de API no cliente.
- Sem rate limiting centralizado.
- Sem controle centralizado das chamadas.
- Sem mecanismo de retry ou backoff.
- Sem validação adequada de schema.
- Tratamento de erros fraco.
- Sem observabilidade.
- Lógica complexa demais no navegador.
Era um MVP forte, mas não uma plataforma de LLM pronta para produção.
Pontos fortes
Ao mesmo tempo, o sistema funcionava e produzia resultados reais.
- Desenvolvimento muito rápido.
- Infraestrutura mínima.
- Alta flexibilidade.
- Controle total pela interface.
- Ajuste manual conveniente.
- Geração modular.
- Fluxo real de produção.
O LLM era uma ferramenta, não o núcleo do sistema.
O que eu faria diferente hoje
Se eu fosse construir de novo hoje, mudaria a arquitetura.
- Mover as chamadas de LLM para um gateway no backend.
- Tirar a chave de API do cliente.
- Adicionar filas e retries.
- Introduzir validação estrita de schema JSON.
- Adicionar logging e tracing.
- Implementar rate limiting.
- Separar a orquestração da interface.
A principal lição
A parte mais interessante para mim é que eu não projetei um sistema de LLM.
Eu estava apenas resolvendo um problema.
Só depois percebi que tinha construído uma arquitetura que hoje se chama orquestração de LLM.
Às vezes boas decisões de engenharia parecem, no começo, caos e intuição. Só depois viram uma arquitetura clara, que dá para melhorar de forma consciente.
O que acontece dentro do modelo
Tudo acima é orquestração em torno de um modelo que já funciona. Uma página interativa pega o outro lado: um controle leva o modelo por mil passos de treino, do acaso à previsão.
Como um modelo de linguagem aprende: esquema interativo