気づかないうちにブラウザでLLMオーケストレーションを作っていた話
LitsellerがGPT API、React、プロンプト、そしてブラウザ側のオーケストレーションを使って書籍カタログの構造化コンテンツを生成した仕組みを、アーキテクチャの視点から振り返ります。
二年前、私はLitsellerを作りました。
そのときはLLMのオーケストレーションも、そうした仕組みの設計も考えていませんでした。目の前の具体的な課題を解いていただけです。書籍カタログ用の構造化コンテンツを、どうすれば素早く生成できるか。
いま振り返ると、あれは本質的に完成したLLMオーケストレーションの仕組みでした。ただ、バックエンドではなくブラウザの中に実装されていただけです。
実際のところ、あれは何だったのか
ここは正しく枠づけておく必要があります。
LitsellerはLLMサービスではありませんでした。
カタログを持つ普通のウェブアプリで、その管理画面の中に、データ生成の道具としてLLMを組み込んだだけです。
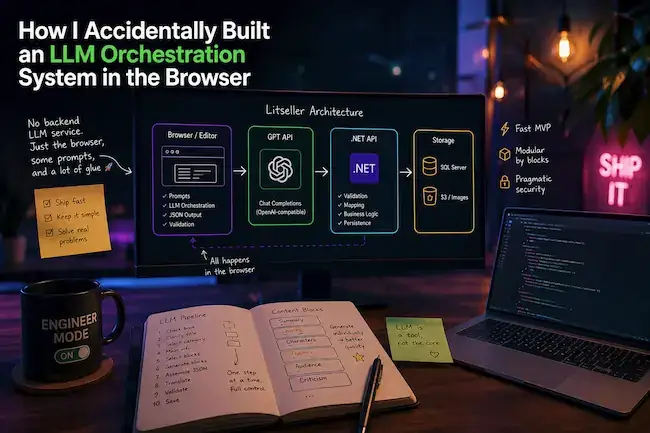
オーケストレーションはすべて単純な流れの中にありました。編集画面、GPT API、JSON、検証、バックエンドへの保存。
- キューはなし。
- ワーカーもなし。
- サーバー側のオーケストレーションもなし。
- 複雑な基盤もなし。
すべてはReactとプロンプト、そしてリクエストの連鎖の上に成り立っていました。
構成
システムは三つの層に分かれていました。
- フロントエンド: Next.jsの管理画面、エディタ、そしてLLMまわりのロジック一式。
- バックエンド: .NETのAPI、検証、永続化。
- ストレージ: SQL ServerとS3。
LLMのロジックはバックエンドにまったく置かれていませんでした。呼び出しはブラウザから直接でした。
生成パイプライン
大きな一回のリクエストではなく、パイプラインを組みました。
- モデルがその本を知っているか確かめる。
- 必要なら書名をはっきりさせる。
- カテゴリーを選ぶ。
- 主要な情報を生成する。
- あらすじ、引用、テーマなどのコンテンツブロックを選ぶ。
- 各ブロックを個別に生成する。
- JSONを組み立てる。
- 内容を他の言語へ翻訳する。
- 結果を検証する。
- 最終データを保存する。
これはもう本物のオーケストレーションでした。専用のオーケストレーションサービスがなかっただけです。
ブロック単位がうまくいった理由
コンテンツをブロックごとに生成したのは、いちばん効いた判断の一つでした。
本のページ全体を一度に生成させることはしませんでした。
- あらすじは個別に生成。
- 登場人物は個別に生成。
- 引用は個別に生成。
- テーマは個別に生成。
おかげで品質を管理しやすくなり、部分だけ作り直せるようになり、JSONが安定し、間違いも減りました。
実質的には、LLMの出力の上に手作業のバージョン管理層を敷いたようなものです。
プロンプト設計
プロンプトは単純でしたが、構造は持たせていました。
- 厳密なJSON形式。
- 明確な指示。
- 魔法は最小限。
文脈は明示的に渡していました。書名、著者、カテゴリー、言語、そして前のブロック。
- 会話の記憶はなし。
- 複雑な状態もなし。
- ツール呼び出しもなし。
もっとも議論を呼ぶ判断
APIキーはlocalStorageに置いていました。
理由は単純です。エディタは公開の画面ではなく、利用者はごく少数で、優先すべきは早く出すことで、バックエンドでのオーケストレーションは仕組みをずっと複雑にしたはずだからです。
意識してそう決めました。危険は理解したうえで受け入れました。
加えて、アクセスは絞り、Cloudflareを使って手作業で守っていました。
弱いところ
いま正直に見れば、弱点ははっきりしています。
- APIキーがクライアント側にある。
- 集中的なレート制限がない。
- 呼び出しを一元的に管理できていない。
- リトライやバックオフの仕組みがない。
- きちんとしたスキーマ検証がない。
- エラー処理が弱い。
- 可観測性がない。
- ブラウザに複雑なロジックを載せすぎ。
強いMVPではありましたが、本番運用に耐えるLLM基盤ではありませんでした。
強いところ
同時に、この仕組みは動き、実際の成果を出していました。
- 開発がとても速い。
- 基盤が最小限。
- 柔軟性が高い。
- 画面から完全に制御できる。
- 手直しがしやすい。
- 生成がモジュール化されている。
- 本番で回る実際の作業手順。
LLMは道具であって、システムの中心ではありませんでした。
いまなら変えるところ
いま同じものを作るなら、構成を変えます。
- LLM呼び出しをバックエンドのゲートウェイへ移す。
- APIキーをクライアントから外す。
- キューとリトライを入れる。
- JSONスキーマの厳密な検証を導入する。
- ログとトレースを足す。
- レート制限を実装する。
- オーケストレーションを画面から切り離す。
いちばんの学び
自分にとっていちばん面白いのは、LLMシステムを設計したわけではない、という点です。
ただ課題を解いていただけでした。
あとになって、いまLLMオーケストレーションと呼ばれる構成を自分が組んでいたのだと気づいたのです。
良い設計判断は、はじめは混沌と直感に見えることがあります。それが明確な構成になり、意識して良くしていけるようになるのは、あとからです。
モデルの中で起きていること
ここまでは、すでに動くモデルの周りをまとめる話でした。インタラクティブなページは反対側を扱います。スライダー1つでモデルを千の学習ステップに通し、でたらめな数から予測までを追えます。
言語モデルはどう学ぶのか: インタラクティブな図