Come ho costruito per caso un sistema di orchestrazione LLM nel browser
Uno sguardo architetturale su come Litseller ha usato l'API di GPT, React, i prompt e l'orchestrazione lato browser per generare contenuti strutturati di un catalogo di libri.
Due anni fa ho costruito Litseller.
In quel momento non pensavo all'orchestrazione di LLM né all'architettura di sistemi del genere. Stavo semplicemente risolvendo un problema preciso: come generare in fretta contenuti strutturati per un catalogo di libri.
Guardandolo oggi, capisco che in sostanza era un sistema completo di orchestrazione LLM. Solo che era implementato non nel backend, ma direttamente nel browser.
Che cos'era davvero
È importante inquadrarlo correttamente.
Litseller non era un servizio LLM.
Era una classica applicazione web con un catalogo, sopra la quale avevo integrato un LLM come strumento di generazione dati dentro l'area di amministrazione.
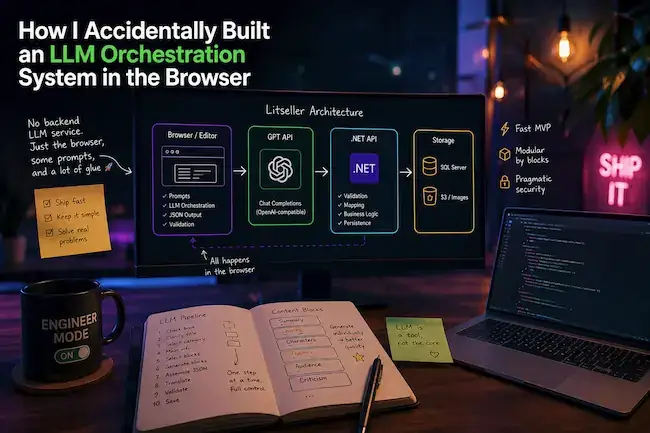
Tutta l'orchestrazione avveniva in un flusso semplice: interfaccia dell'editor, API di GPT, JSON, validazione, salvataggio nel backend.
- Niente code.
- Niente worker.
- Niente orchestrazione lato server.
- Niente infrastruttura complessa.
Tutto era costruito su React, prompt e catene di richieste.
Architettura
Il sistema era diviso in tre livelli.
- Frontend: area di amministrazione in Next.js, editor e tutta la logica LLM.
- Backend: API in .NET, validazione e persistenza.
- Archiviazione: SQL Server e S3.
La logica LLM non stava affatto nel backend. Le chiamate partivano direttamente dal browser.
Pipeline di generazione
Invece di una sola richiesta grande, ho costruito una pipeline.
- Verificare se il modello conosce il libro.
- Chiarire il titolo se necessario.
- Scegliere una categoria.
- Generare le informazioni principali.
- Scegliere i blocchi di contenuto, come sinossi, citazioni, temi e altre sezioni.
- Generare ogni blocco separatamente.
- Assemblare il JSON.
- Tradurre il contenuto in altre lingue.
- Validare il risultato.
- Salvare i dati finali.
Era già orchestrazione vera e propria, solo senza un servizio di orchestrazione separato.
Perché i blocchi hanno funzionato bene
Generare il contenuto per blocchi è stata una delle decisioni più forti.
Non chiedevo al modello di generare tutta la pagina del libro in una volta.
- La sinossi veniva generata a parte.
- I personaggi venivano generati a parte.
- Le citazioni venivano generate a parte.
- I temi venivano generati a parte.
Questo mi dava un miglior controllo della qualità, la possibilità di rigenerare singole parti, un JSON più stabile e meno errori.
In pratica è diventato un livello manuale di controllo di versione sopra l'output del LLM.
Prompt engineering
I prompt erano semplici, ma strutturati.
- Formato JSON rigoroso.
- Istruzioni chiare.
- Magia al minimo.
Il contesto veniva passato in modo esplicito: titolo, autore, categorie, lingua e blocchi precedenti.
- Nessuna memoria della conversazione.
- Nessuno stato complesso.
- Nessun tool calling.
La decisione più discutibile
La chiave API era salvata nel localStorage.
Il motivo era semplice: l'editor non era un'interfaccia pubblica, gli utenti erano pochissimi, la priorità era lanciare in fretta e l'orchestrazione nel backend avrebbe reso il sistema molto più complesso.
È stata una decisione consapevole. I rischi erano compresi e accettati.
In più l'accesso era limitato e protetto manualmente tramite Cloudflare.
Punti deboli
A guardarlo onestamente oggi, i punti deboli sono evidenti.
- Chiave API sul client.
- Nessun rate limiting centralizzato.
- Nessun controllo centralizzato delle chiamate.
- Nessun meccanismo di retry o backoff.
- Nessuna vera validazione dello schema.
- Gestione degli errori debole.
- Nessuna osservabilità.
- Troppa logica complessa nel browser.
Era un MVP solido, ma non una piattaforma LLM pronta per la produzione.
Punti di forza
Allo stesso tempo il sistema funzionava e dava risultati reali.
- Sviluppo molto rapido.
- Infrastruttura minima.
- Grande flessibilità.
- Controllo totale dall'interfaccia.
- Rifinitura manuale comoda.
- Generazione modulare.
- Flusso di produzione reale.
Il LLM era uno strumento, non il cuore del sistema.
Che cosa farei diversamente oggi
Se lo costruissi di nuovo oggi, cambierei l'architettura.
- Spostare le chiamate LLM in un gateway nel backend.
- Togliere la chiave API dal client.
- Aggiungere code e retry.
- Introdurre una validazione rigorosa dello schema JSON.
- Aggiungere logging e tracing.
- Implementare il rate limiting.
- Separare l'orchestrazione dall'interfaccia.
La lezione principale
La parte più interessante per me è che non ho progettato un sistema LLM.
Stavo semplicemente risolvendo un problema.
Solo dopo mi sono reso conto di aver costruito un'architettura che oggi si chiama orchestrazione LLM.
A volte le buone decisioni ingegneristiche all'inizio sembrano caos e intuito. Solo dopo diventano un'architettura chiara, che si può migliorare in modo consapevole.
Cosa succede dentro il modello
Tutto quanto sopra è orchestrazione attorno a un modello che già funziona. Una pagina interattiva prende l'altro lato: un cursore porta il modello attraverso mille passi di addestramento, dal caso alla previsione.
Come impara un modello linguistico: schema interattivo