我是怎么稀里糊涂在浏览器里做出一套 LLM 编排系统的
从架构角度回看 Litseller 如何用 GPT API、React、提示词和浏览器端编排,生成一个图书目录的结构化内容。
两年前,我做了 Litseller。
那会儿我没在想什么 LLM 编排,也没在想这类系统的架构。我只是在解决一个具体问题:怎么快速生成图书目录用的结构化内容。
如今回头看,我明白那本质上就是一套完整的 LLM 编排系统。只不过它没实现在后端,而是直接跑在浏览器里。
它究竟是什么
这一点得说准确。
Litseller 不是一个 LLM 服务。
它是一个带目录的普通 Web 应用,我只是在它的后台里嵌了一个 LLM,当作生成数据的工具。
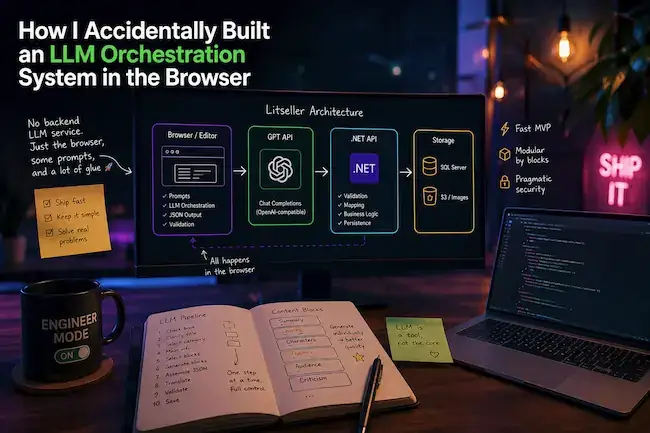
全部编排都发生在一条简单的流程里:编辑界面、GPT API、JSON、校验、写回后端。
- 没有队列。
- 没有 worker。
- 没有服务端编排。
- 没有复杂的基础设施。
一切都建立在 React、提示词和一串串请求之上。
架构
系统分成三层。
- 前端:Next.js 后台、编辑器,以及全部 LLM 逻辑。
- 后端:.NET API、校验和持久化。
- 存储:SQL Server 和 S3。
LLM 逻辑根本没放在后端。调用直接从浏览器发出。
生成流水线
我没有用一个大请求,而是搭了一条流水线。
- 确认模型是否知道这本书。
- 必要时把书名问清楚。
- 选一个分类。
- 生成主要信息。
- 挑选内容区块,比如梗概、引文、主题等。
- 逐块单独生成。
- 拼装 JSON。
- 把内容翻成其他语言。
- 校验结果。
- 保存最终数据。
这已经是真正的编排了,只是没有一个独立的编排服务。
为什么分块效果好
按区块生成内容,是当时最见效的决定之一。
我没让模型一口气生成整个图书页面。
- 梗概单独生成。
- 人物单独生成。
- 引文单独生成。
- 主题单独生成。
这让我对质量的把控更好,能只重做其中某一块,JSON 更稳定,出错也更少。
实际上,它变成了盖在 LLM 输出之上的一层手工版本控制。
提示词设计
提示词很简单,但是有结构。
- 严格的 JSON 格式。
- 清楚的指令。
- 尽量少的玄学。
上下文是显式传进去的:书名、作者、分类、语言,以及前面的区块。
- 没有对话记忆。
- 没有复杂状态。
- 没有工具调用。
最有争议的一个决定
API key 存在 localStorage 里。
原因很简单:编辑器不是对外的界面,用户极少,首要目标是快点上线,而后端编排会让系统复杂得多。
这是一个有意识的决定。风险我清楚,也接受。
另外,访问是受限的,并且通过 Cloudflare 手工做了防护。
薄弱之处
今天老实看,薄弱的地方一目了然。
- API key 放在客户端。
- 没有集中的限流。
- 没有对调用的集中管控。
- 没有重试或退避机制。
- 没有像样的 schema 校验。
- 错误处理很弱。
- 没有可观测性。
- 浏览器里塞了太多复杂逻辑。
它是一个不错的 MVP,但不是能扛生产的 LLM 平台。
可取之处
与此同时,这套东西是能跑的,也确实产出了成果。
- 开发非常快。
- 基础设施极少。
- 灵活度高。
- 通过界面完全可控。
- 手工微调很方便。
- 生成是模块化的。
- 真正在生产里跑的工作流。
LLM 是一件工具,不是系统的核心。
今天我会怎么改
如果今天重做一遍,我会改掉架构。
- 把 LLM 调用挪进后端网关。
- 把 API key 从客户端拿掉。
- 加上队列和重试。
- 引入严格的 JSON schema 校验。
- 补上日志和链路追踪。
- 实现限流。
- 把编排从界面里拆出来。
最大的收获
对我来说最有意思的是:我并没有去设计一套 LLM 系统。
我只是在解决一个问题。
直到后来我才意识到,自己搭出来的正是今天被称作 LLM 编排的那种架构。
有时候,好的工程判断一开始看着像混乱和直觉。要等到后来,它们才变成一套清晰的架构,可以被有意识地一点点改好。
模型内部发生了什么
以上都是围绕一个已经能用的模型做编排。有一个互动页面讲的是另一面:一个滑块带模型走过一千个训练步,从随机数字一路到预测。
语言模型是怎么学会的: 互动示意图