Comment j'ai construit par accident un système d'orchestration de LLM dans le navigateur
Un regard architectural sur la façon dont Litseller a utilisé l'API GPT, React, des prompts et une orchestration côté navigateur pour générer le contenu structuré d'un catalogue de livres.
Il y a deux ans, j'ai construit Litseller.
À ce moment-là, je ne pensais ni à l'orchestration de LLM ni à l'architecture de tels systèmes. Je résolvais simplement un problème précis : comment générer rapidement du contenu structuré pour un catalogue de livres.
Avec le recul, je comprends que c'était au fond un système complet d'orchestration de LLM. Il était simplement implémenté non pas côté serveur, mais directement dans le navigateur.
Ce que c'était réellement
Il est important de bien poser le cadre.
Litseller n'était pas un service de LLM.
C'était une application web classique avec un catalogue, dans laquelle j'avais intégré un LLM comme outil de génération de données au sein de l'espace d'administration.
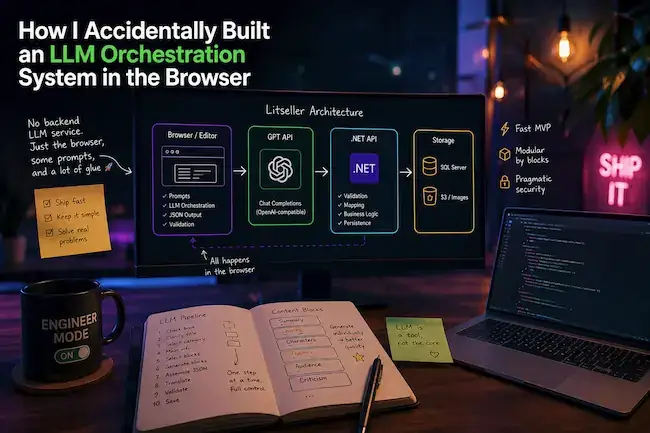
Toute l'orchestration se faisait selon un flux simple : interface d'édition, API GPT, JSON, validation, sauvegarde côté serveur.
- Pas de files d'attente.
- Pas de workers.
- Pas d'orchestration côté serveur.
- Pas d'infrastructure complexe.
Tout reposait sur React, des prompts et des chaînes de requêtes.
Architecture
Le système était découpé en trois couches.
- Frontend : espace d'administration Next.js, éditeur et toute la logique LLM.
- Backend : API .NET, validation et persistance.
- Stockage : SQL Server et S3.
La logique LLM ne vivait pas du tout côté serveur. Les appels partaient directement du navigateur.
Pipeline de génération
Au lieu d'une grosse requête unique, j'ai construit un pipeline.
- Vérifier si le modèle connaît le livre.
- Préciser le titre si nécessaire.
- Choisir une catégorie.
- Générer les informations principales.
- Choisir les blocs de contenu : résumé, citations, thèmes et autres sections.
- Générer chaque bloc séparément.
- Assembler le JSON.
- Traduire le contenu dans d'autres langues.
- Valider le résultat.
- Sauvegarder les données finales.
C'était déjà de la vraie orchestration, simplement sans service d'orchestration dédié.
Pourquoi les blocs ont bien fonctionné
Générer le contenu par blocs a été l'une des meilleures décisions.
Je ne demandais pas au modèle de générer toute la page du livre d'un coup.
- Le résumé était généré séparément.
- Les personnages étaient générés séparément.
- Les citations étaient générées séparément.
- Les thèmes étaient générés séparément.
Cela m'a donné un meilleur contrôle de la qualité, la possibilité de régénérer des parties isolées, un JSON plus stable et moins d'erreurs.
En pratique, c'est devenu une couche manuelle de gestion de versions au-dessus de la sortie du LLM.
Ingénierie des prompts
Les prompts étaient simples, mais structurés.
- Format JSON strict.
- Instructions claires.
- Magie minimale.
Le contexte était passé explicitement : titre, auteur, catégories, langue et blocs précédents.
- Pas de mémoire de conversation.
- Pas d'état complexe.
- Pas de tool calling.
La décision la plus contestable
La clé d'API était stockée dans le localStorage.
La raison était simple : l'éditeur n'était pas une interface publique, les utilisateurs étaient très peu nombreux, la priorité était de lancer vite, et une orchestration côté serveur aurait rendu le système bien plus complexe.
C'était une décision consciente. Les risques étaient compris et acceptés.
De plus, l'accès était restreint et protégé manuellement via Cloudflare.
Points faibles
En regardant honnêtement aujourd'hui, les points faibles sautent aux yeux.
- Clé d'API côté client.
- Pas de limitation de débit centralisée.
- Pas de contrôle centralisé des appels.
- Pas de mécanisme de retry ni de backoff.
- Pas de vraie validation de schéma.
- Gestion des erreurs faible.
- Pas d'observabilité.
- Trop de logique complexe dans le navigateur.
C'était un MVP solide, mais pas une plateforme LLM prête pour la production.
Points forts
En même temps, le système fonctionnait et produisait de vrais résultats.
- Développement très rapide.
- Infrastructure minimale.
- Grande souplesse.
- Contrôle total via l'interface.
- Retouche manuelle commode.
- Génération modulaire.
- Vrai flux de production.
Le LLM était un outil, pas le cœur du système.
Ce que je ferais autrement aujourd'hui
Si je le reconstruisais aujourd'hui, je changerais l'architecture.
- Déplacer les appels LLM dans une passerelle côté serveur.
- Retirer la clé d'API du client.
- Ajouter des files d'attente et des retries.
- Introduire une validation stricte du schéma JSON.
- Ajouter du logging et du tracing.
- Mettre en place une limitation de débit.
- Séparer l'orchestration de l'interface.
L'enseignement principal
Ce qui m'intéresse le plus, c'est que je n'ai pas conçu un système LLM.
Je résolvais simplement un problème.
Ce n'est que plus tard que j'ai compris avoir construit une architecture qu'on appelle aujourd'hui orchestration de LLM.
Parfois, les bonnes décisions d'ingénierie ressemblent d'abord à du chaos et à de l'intuition. Ce n'est que plus tard qu'elles deviennent une architecture claire, que l'on peut améliorer consciemment.
Ce qui se passe dans le modèle
Tout ce qui précède est de l'orchestration autour d'un modèle qui fonctionne déjà. Une page interactive prend l'autre côté : un curseur mène le modèle à travers mille étapes d'entraînement, du hasard à la prédiction.
Comment un modèle de langue apprend : schéma interactif