Як я випадково побудував систему оркестрації LLM у браузері
Архітектурний погляд на те, як Litseller використовував GPT API, React, промпти й оркестрацію на боці браузера, щоб генерувати структурований контент книжкового каталогу.
Два роки тому я зробив Litseller.
Тоді я не думав ні про оркестрацію LLM, ні про архітектуру таких систем. Я просто розв'язував конкретну задачу: як швидко генерувати структурований контент для книжкового каталогу.
Озираючись зараз, я розумію, що це по суті була повноцінна система оркестрації LLM. Просто реалізована не на бекенді, а прямо в браузері.
Чим це було насправді
Важливо правильно це окреслити.
Litseller не був LLM-сервісом.
Це був класичний вебзастосунок із каталогом, поверх якого я вбудував LLM як інструмент генерації даних в адмінці.
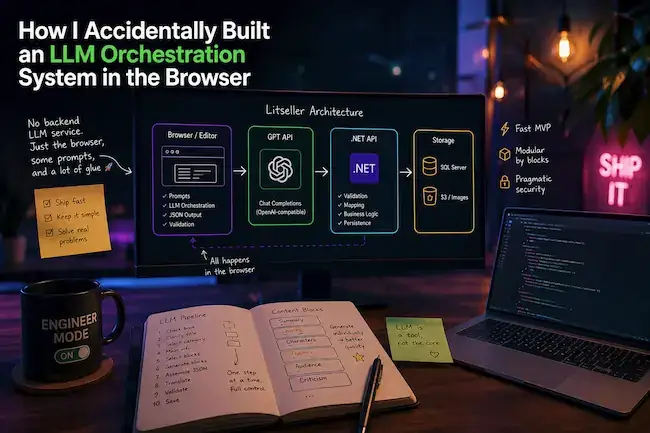
Уся оркестрація відбувалася в простому потоці: інтерфейс редактора, GPT API, JSON, валідація, збереження на бекенді.
- Жодних черг.
- Жодних воркерів.
- Жодної серверної оркестрації.
- Жодної складної інфраструктури.
Усе трималося на React, промптах і ланцюжках запитів.
Архітектура
Систему було поділено на три шари.
- Фронтенд: адмінка на Next.js, редактор і вся логіка LLM.
- Бекенд: API на .NET, валідація і збереження.
- Сховище: SQL Server і S3.
Логіка LLM узагалі не жила на бекенді. Виклики йшли просто з браузера.
Конвеєр генерації
Замість одного великого запиту я побудував конвеєр.
- Перевірити, чи модель знає книжку.
- За потреби уточнити назву.
- Обрати категорію.
- Згенерувати основну інформацію.
- Обрати блоки контенту: короткий зміст, цитати, теми та інші розділи.
- Згенерувати кожен блок окремо.
- Зібрати JSON.
- Перекласти контент іншими мовами.
- Перевірити результат.
- Зберегти фінальні дані.
Це вже була справжня оркестрація, просто без окремого сервісу оркестрації.
Чому блоки спрацювали добре
Генерація контенту блоками стала одним із найсильніших рішень.
Я не просив модель згенерувати всю сторінку книжки за один раз.
- Короткий зміст генерувався окремо.
- Персонажі генерувалися окремо.
- Цитати генерувалися окремо.
- Теми генерувалися окремо.
Це дало кращий контроль якості, можливість перегенерувати окремі частини, стабільніший JSON і менше помилок.
На практиці це перетворилося на ручний шар контролю версій над виводом LLM.
Промпт-інжиніринг
Промпти були прості, але структуровані.
- Суворий формат JSON.
- Чіткі інструкції.
- Мінімум магії.
Контекст передавався явно: назва, автор, категорії, мова і попередні блоки.
- Без пам'яті розмови.
- Без складного стану.
- Без tool calling.
Найсуперечливіше рішення
Ключ API зберігався в localStorage.
Причина була проста: редактор не був публічним інтерфейсом, користувачів було дуже мало, пріоритетом було швидко запуститися, а оркестрація на бекенді зробила б систему значно складнішою.
Це було свідоме рішення. Ризики були зрозумілі й прийняті.
До того ж доступ був обмежений і захищений вручну через Cloudflare.
Слабкі місця
Якщо чесно подивитися сьогодні, слабкі місця очевидні.
- Ключ API на клієнті.
- Немає централізованого обмеження частоти запитів.
- Немає централізованого контролю викликів.
- Немає механізму повторів чи backoff.
- Немає нормальної валідації схеми.
- Слабка обробка помилок.
- Немає спостережуваності.
- Забагато складної логіки в браузері.
Це був сильний MVP, але не готова до продакшену LLM-платформа.
Сильні місця
Водночас система працювала і давала реальний результат.
- Дуже швидка розробка.
- Мінімальна інфраструктура.
- Висока гнучкість.
- Повний контроль через інтерфейс.
- Зручне ручне доопрацювання.
- Модульна генерація.
- Справжній робочий процес у продакшені.
LLM був інструментом, а не ядром системи.
Що я зробив би інакше сьогодні
Якби будував це сьогодні, я змінив би архітектуру.
- Перенести виклики LLM у бекенд-шлюз.
- Прибрати ключ API з клієнта.
- Додати черги і повтори.
- Запровадити сувору валідацію JSON-схеми.
- Додати логування і трасування.
- Реалізувати обмеження частоти запитів.
- Відокремити оркестрацію від інтерфейсу.
Головний висновок
Найцікавіше для мене те, що я не проєктував LLM-систему.
Я просто розв'язував задачу.
Лише згодом я усвідомив, що побудував архітектуру, яку сьогодні називають оркестрацією LLM.
Іноді хороші інженерні рішення спершу виглядають як хаос і інтуїція. І тільки потім стають зрозумілою архітектурою, яку можна свідомо покращувати.
Що відбувається всередині моделі
Усе вище це оркестрація навколо моделі, яка вже працює. Інтерактивна сторінка бере інший бік: один повзунок проводить модель крізь тисячу кроків навчання, від випадкових чисел до передбачення.
Як навчається мовна модель: інтерактивна схема